AI職場溝通術:LLM大型語言模型應用技巧
104學習

LLM
指的是大型語言模型,透過大量文字資料訓練,能理解並生成自然語言內容。在職場上,這項技能能協助自動化文件撰寫、客服回覆、資料分析與語意理解,大幅提升工作效率與準確度。懂得操作和應用這類模型,對於行銷、客服、內容創作、研發等職務尤為重要,能為企業帶來競爭優勢。掌握相關技術,也代表具備跨領域整合與數位轉型的能力,未來職場競爭力將明顯提升。

提升你的實力,朝專業更進一步
精選課程
充實自己,讓能力持續成長
從零開始 Python × Ollama 實戰教學:打造企業本地LLM應用程式
【回放影片】NVIDIA DLI官方課程 - 快速開發LLM應用|開課說明
最快入門與實作大型語言模型(LLM、DeepSeek)!做中學更輕鬆!
【早鳥優惠:領$1,300券現折】NVIDIA DLI官方課程 - 快速開發LLM應用|11/22 (日), 11/29(日) 兩天假日直播課
自然語言處理與大型語言模型|本課程為線上課
深度學習之問答系統實作|本課程為線上課
AI邊緣運算實作TensorFlowLite for MCU【本課程為線上課,報名後專員會提供上課資訊】
成為 AI 科學家|用文字探勘與自然語言處理萃取文字數據精華,逐步成為數據統整大師
人工智慧-機器學習【本課程為線上課,報名後專員會提供上課資訊】
精選證照
考取專業證照,讓能力被市場看見
大型語言模型(LLM)課程認證
線上課程約8小時
這堂入門微學習課程說明大型語言模型 (LLM) 的定義與用途,以及如何調整提示來提高 LLM 成效。這堂課程也會介紹多項 Google 工具,協助您自行開發生成式 AI 應用程式。
完成此活動,贏取徽章!向世界展示您掌握的技能,拓展雲端領域的職業之路。
課程目標:
● 定義大型語言模型 (LLM)
● 說明 LLM 的用途
● 解釋「提示調整」
● 介紹 Google 的生成式 AI 開發工具
Google
LCE
LCE證照旨在評估個人在語言溝通與表達能力上的專業水平,涵蓋聽說讀寫四項技能,強調實務應用與職場需求的結合。持有此證照代表具備良好的語言理解與應用能力,能有效進行跨文化交流,提升工作效率與團隊合作,適合各行各業追求語言能力提升者。
SAIR/GNU-Wave
MLCE
MLCE證照專注於機器學習與雲端運算技術,涵蓋資料前處理、模型建構與優化,以及在雲端平台上的部署與管理能力。持有此證照代表具備運用機器學習方法解決實際問題的專業技能,並能熟練操作主流雲端服務,提升企業數據分析與智能應用的效能。此證照適合數據科學家、軟體工程師及IT專業人員,助力職涯發展與技術升級。
SAIR/GNU-Wave
ICDL-人工智慧
ICDL國際認證符合現今產業趨勢,包含雲端協同作業、數位行銷、運算思維與程式設計、數據分析、專案規劃及必要之資訊安全..等能力,皆可完整學習,從而快速的應用在新技術及工作上。在全球超過100個國家的夥伴網路,以40多種語言授課認證,而財團法人電腦技能基金會(CSF)為ICDL台灣總代理。
ICDL Asia
ICDL-專案規劃
ICDL國際認證符合現今產業趨勢,包含雲端協同作業、數位行銷、運算思維與程式設計、數據分析、專案規劃及必要之資訊安全..等能力,皆可完整學習,從而快速的應用在新技術及工作上。在全球超過100個國家的夥伴網路,以40多種語言授課認證,而財團法人電腦技能基金會(CSF)為ICDL台灣總代理。
ICDL Asia
LPIC Level 1
LPI 於1999 年 10 月 25 日成立,為一個加拿大非營利組織,總部設於多倫多。LPI嘗試集合各方活躍團體、公司、學術專業等各界來共同贊助支持 LPI 及其中心目標。LPI 被公認為首處提倡「使用開放源碼和自由軟體」的組織,因此,LPI是一個完完全全公正、公開且公平的認證機構。
LPI的考試技術和內容並不受限於哪家廠商 (例如:RedHat, SUSE, Debian等) 的操作環境,而是測驗受測者對於整個Linux架構的熟練度、了解度、以及應用程度等。因此,只要取得LPI證照,就可以證明取得認證的您,對於Linux系統有相當程度的了解。lt;brgt;目前LPI的考試分為三個等級,Level 1、Level 2以及Level 3 。lt;brgt;LPIC(Linux Professional Institute Certification (LPIC) ) Level1所需具備的知識:
1.熟悉 Unix 指令
2.系統管理(帳號及群組的管理、權限的管理、系統備份、復原、關機及重新開機)
3.能夠安裝及設定Linux工作站(包括 X-Window),並可以透過LAN或Modem 連上網路
LPI(Linux Professional Institute)
精選貼文,掌握第一手知識
Vibe Coding × ASP.NET Core LLM 開發實戰班
AI 時代,程式不只是寫,還能「聊」出來!
學會 Vibe Coding,
讓你用自然語言操控程式、生成 API、打造 AI Agent,
真正結合後端工程 + AI 實戰。
🌟 你將學到
✅ 精通 C# / ASP.NET Core(MVC、API、雲端部署)
✅ LLM × Vibe Coding 實戰,從 Prompt 到應用落地
✅ AI Agent 開發、NLP、影像辨識、模型部署
✅ 使用 Azure / VS Code / Cursor 實作
✅ 分組 Side Project,實務專題製作
💡 課程特色
1⃣️ 小班真人線上(10 人以下),Discord 即時答疑。
2⃣️ 避開平日上班時間,便於在職者學習。
3⃣️ 全程錄影,缺課可回放
4⃣️ 真實專案模擬業界開發流程
🎯 適合誰?�想成為 AI 工程師的畢業生
✅ 有基礎的在職工程師
✅ 企業中高階主管。
✅ 創業想做 MVP 的產品人。
🗓️ 開課資訊
預計開課:2025/12月 平日晚上(日期另行公告)
課程時數:共計288小時 / 約32週
上課方式:全線上
⚡ 名額有限,立即報名,搶先升級你的開發力!
報名連結👇
https://user135527.pse.is/7ze3yz
LLM SEO與ChatGPT SEO入門:AEO答案引擎優化解析
上禮拜幫一家連鎖補習班上內部教育訓練課,投影片才放到第三頁,台下一位行銷主管就舉手打斷我:「老師,我上星期收到三份不同代理商的提案,一份主打SEO,一份主打GEO,一份主打AEO,還有一份說他們專門做LLM SEO,看起來都很像,到底哪個才是我真正該花錢的?」這個問題我這半年被問了不下十次,每次都要重新畫一次圖跟客戶解釋清楚。我平常的工作內容大概一半時間在處理客戶網站在Google的排名,另一半時間在研究客戶的品牌內容有沒有機會被ChatGPT、Perplexity這類工具引用回答,這幾個名詞之間的差異,幾乎每週都要重新解釋一次。這篇文章想用比較口語、比較貼近實際操作的方式,把這幾個容易搞混的概念講清楚,尤其是「seo geo是什麼」這個大家最常問的問題,還有「chatgpt seo」到底要從哪裡下手。
seo geo是什麼,先把地圖畫出來
如果把「讓潛在客戶找到你」這件事想成一張地圖,SEO、GEO、AEO、LLM SEO其實是同一張地圖上不同的路線,目的地都是「被找到、被推薦」,只是走的路徑跟服務的對象不一樣。我通常會這樣跟客戶拆解:
第一,傳統SEO,全名Search Engine Optimization,做的是針對Google這類搜尋引擎的網頁排名優化,核心邏輯是關鍵字、網站結構、外部連結、使用者體驗這些訊號,讓網站在搜尋結果頁面盡量排在前面,讓使用者點進去。
第二,GEO,全名Generative Engine Optimization,做的是針對生成式引擎的優化,包含ChatGPT搜尋功能、Google的AI Overview、Perplexity這類會直接生成一段整理好答案的工具,重點不再只是排名第幾,而是你的品牌內容有沒有機會被這些引擎讀進去、整理進答案裡。
第三,AEO,也就是答案引擎優化(Answer Engine Optimization),這個詞比較早出現在語音助理、智慧音箱的時代,例如使用者問Siri或Google助理某個問題,系統要從網路上找出一個最精準的答案唸出來,網站經營者要優化的就是「讓自己的內容成為那個被唸出來的答案」。現在AEO的概念已經延伸到所有會直接產生答案的場景,跟GEO的精神高度重疊,可以理解成GEO的前身,或是同一件事在不同階段的說法。這裡要特別澄清一下,答案引擎優化(AEO)這個縮寫在某些產業領域也被用來指自動化出口報關,跟本文討論的內容完全是兩回事,本文從頭到尾談的AEO都是指Answer Engine Optimization這個行銷優化的概念,跟報關流程無關。
第四,LLM SEO,指的是針對大型語言模型(Large Language Model)本身的優化,範圍比GEO更聚焦在ChatGPT、Claude、Gemini這類對話式AI,因為這些工具生成答案的方式跟搜尋引擎的生成式摘要又不太一樣,牽涉到模型訓練資料、即時檢索能力、品牌在網路上被提及的頻率跟語境,所以會被獨立拿出來討論。
簡單整理一下這四個詞的關係,可以這樣記,傳統SEO服務的對象是搜尋引擎的排名演算法,GEO服務的對象是各種生成式AI引擎,AEO服務的對象是直接輸出答案的系統,LLM SEO則是聚焦在ChatGPT等語言模型這個更具體的子集合。它們不是互相取代的關係,而是隨著使用者查資料的習慣從點連結變成直接看答案,優化的重點跟著往後延伸,四個詞常常同時出現在同一份策略裡面。
舉個實際會遇到的例子,假設有人想找「台北辦公室空間消毒服務」,如果他打開Google搜尋,看到的是一排網站連結,這時候比的是傳統SEO的排名;如果他改用ChatGPT或Google的AI Overview直接問「台北有哪些辦公室消毒服務推薦」,系統可能會直接整理出幾家業者的名稱跟特色給他看,這時候比的就是GEO跟LLM SEO;如果他是用語音助理隨口問「附近有沒有推薦的消毒公司」,系統唸出來的那個答案,背後就是AEO在處理的場景。同一個使用者,同一個需求,卻可能同時經過這三種不同的優化邏輯,這也是為什麼企業現在不太可能只靠單一種優化方式就把曝光顧好。
chatgpt seo怎麼做,跟傳統排名邏輯差在哪
很多客戶第一次聽到chatgpt seo,直覺反應是「那是不是把原本做SEO的關鍵字文章直接丟給ChatGPT就好」,但實務上兩者的運作邏輯真的不太一樣。Google傳統排名比較像是先把全世界的網頁分類編號,使用者輸入關鍵字之後,系統從龐大的索引裡挑出最相關、最權威的頁面排序給你選;而ChatGPT在回答問題時,很多時候是先用自己既有的知識生成一個答案架構,如果開啟了即時搜尋功能,才會再去抓幾個網頁來源做補充跟引用,換句話說,你的內容能不能「被引用進答案裡」,跟能不能「被抓取到、被判斷為可信來源」關係更大,而不只是關鍵字密度或版面排名。
根據我們實際操作客戶案例的經驗,chatgpt seo可以從幾個方向著手。
第一,內容要用清楚的問答結構呈現,把讀者可能會問的問題直接當成段落標題寫出來,段落開頭就給出明確結論,再補充說明跟數據,這種結構對語言模型抓取重點特別友善,因為模型在整理答案時,傾向直接擷取結構清楚、語意完整的段落。
第二,強化品牌在網路上被提及的一致性,包含官網、社群、新聞稿、第三方評論網站,因為語言模型判斷一個品牌或說法可不可信,很大程度來自於多個來源是不是講出一致的資訊,如果同樣的服務內容在不同地方寫法差異很大,反而會降低被引用的機會。
第三,善用結構化資料標記,例如常見問題、產品規格、評價分數等等,這些標記除了幫助傳統搜尋引擎理解頁面內容,也能讓生成式引擎更容易解析頁面的邏輯,轉換成答案的一部分。
第四,持續更新內容的時效性,尤其是價格、規格、法規這類容易變動的資訊,因為語言模型如果抓到過時資料,即使把你的品牌寫進答案裡,也可能是錯誤的版本,長期反而傷害信任度。
第五,定期檢查自己的品牌在ChatGPT、Perplexity這類工具裡實際被回答出來的內容,跟自己網站上寫的是否一致,如果發現系統引用的價格、服務項目或聯絡方式跟現況有落差,通常代表某個來源頁面資訊過舊或矛盾,需要回頭修正,這個檢查習慣跟以前做SEO時盯排名報表的邏輯很像,只是監測的對象換成了AI生成的答案內容。
我自己觀察到,很多企業想要同時把SEO、GEO、AEO、LLM SEO這幾件事都佈局起來,常常卡在人力跟專業分工上,畢竟每一項牽涉的技術細節跟需要監測的平台都不太一樣,這也正是戰國策SEO/GEO服務專門在處理的事情,把傳統排名優化跟生成式引擎、語言模型的曝光策略整合在同一套規劃裡面執行,客戶不需要自己拆成好幾個專案分別發包。
答案引擎優化(AEO)具體怎麼落地
前面提到答案引擎優化(AEO)的核心精神,是讓自己的內容有機會成為系統直接輸出的那個答案,實務上我會建議先從自己產業裡使用者最常問的問題清單著手,把這些問題一題一題整理成獨立段落,每個答案盡量控制在三到五句話之內,先講結論再補充理由,這種長度跟結構最容易被系統整段擷取。
再來是善用FAQ頁面跟結構化資料,很多語音助理跟答案引擎在讀取網頁時,會優先辨識標記過的問答內容,如果網站本身就有清楚標示的常見問題區塊,等於幫系統先做好一層篩選跟分類的工作。
另外,答案的來源可信度也很重要,同一個問題,如果能在官網、產業媒體、社群平台上都有一致且對應的說明,系統會更容易把某個品牌判定為該領域的權威來源,進而優先引用。這跟傳統SEO裡面強調外部連結、品牌權威的邏輯是相通的,只是呈現的載體從網頁排名變成了語音或文字答案。
我自己實際操作時,還會提醒客戶注意問句的多樣性,同一個需求,使用者可能會用很不一樣的方式發問,例如有人問「消毒服務費用」,有人問「辦公室除菌大概多少錢」,答案引擎優化(AEO)不是只針對一種標準問句寫一段答案就結束,而是要盡量涵蓋同一個意圖底下常見的幾種問法,這樣不管使用者實際輸入哪一種說法,系統都比較有機會對應到你準備好的內容。
常見問題
Q:做了chatgpt seo之後,一定會被ChatGPT引用嗎?
A:不會百分之百保證,因為語言模型的生成過程有一定的隨機性,而且不是每次提問都會啟動即時搜尋,但把內容結構、品牌一致性、時效性都做好,確實可以提高被抓取跟引用的機率,這跟傳統SEO一樣,是提高機率而不是保證結果。
Q:GEO跟AEO是不是同一件事,要分開做嗎?
A:兩者精神很接近,差別在於AEO的概念比較早出現在語音助理跟單一答案的情境,GEO則涵蓋更廣的生成式引擎生態,實務操作上很多做法是共用的,不需要完全切割成兩個獨立專案,但規劃時可以分別檢視不同平台的表現。
Q:中小企業有必要一次把SEO、GEO、AEO、LLM SEO都做齊嗎?
A:不一定要一次到位,可以先從既有SEO基礎補強內容結構跟問答格式開始,同時觀察自己產業的使用者查資料習慣有沒有明顯轉向AI工具,再決定資源怎麼分配,比較務實的做法是先盤點現況,再排優先順序。
Q:LLM SEO需要跟傳統SEO團隊分開找人做嗎?
A:不一定,很多基本功是共通的,例如內容品質、網站架構、品牌一致性,差異主要在監測工具跟部分內容呈現方式,由同一個團隊或同一個服務窗口整合處理,通常會比拆成兩批人馬各做各的更有效率,也比較不會出現說法不一致的狀況。
寫到這裡,回頭看SEO、GEO、AEO、LLM SEO這幾個詞,其實不用把它們當成互相競爭的技術,比較像是使用者查資料的管道從單純點連結,逐漸擴展到直接看AI生成的答案,企業的內容策略也跟著要涵蓋更多場景。戰國策集團在數位服務這個領域經營超過26年,服務過三萬多家企業客戶,這幾年也持續在跟著這些工具的變化調整操作方法,如果你正在思考自己的網站跟品牌內容要怎麼同時兼顧傳統排名跟AI引擎的曝光,歡迎找我們聊聊,一起盤點目前的狀況,規劃合適的優先順序。
如果想進一步了解SEO、GEO、AEO、LLM SEO要怎麼整合規劃,歡迎透過以下方式聯繫我們。
戰國策SEO/GEO服務
諮詢網站:hotels.com.tw
服務專線:0800-003-191
LINE ID:@119m
ChatGPT SEO怎麼做?LLM SEO與AEO答案引擎優化完整解析
有天晚上我自己在家隨口問ChatGPT某個地區有哪些不錯的月子中心,看著它一口氣列出五家,還簡單說明各自的特色,我當下第一個念頭是,這五家業者到底做了什麼,才能被AI這樣直接點名推薦。隔天我把這個問題帶回辦公室跟同事討論,才發現這正是這半年客戶問我最多次的問題:ChatGPT SEO到底要怎麼做,為什麼有些品牌會被提到,有些連邊都沾不上。這篇文章我想從ChatGPT實際生成答案的運作邏輯出發,把LLM SEO跟AEO答案引擎優化這兩個概念拆解清楚,也整理幾個實務上可以馬上動手調整的方向。
【先搞懂ChatGPT怎麼生成一個答案,才知道從哪裡下手】
要做好ChatGPT SEO,得先理解它產生答案的基本邏輯。當使用者提出一個問題,ChatGPT搜尋功能會先進行類似搜尋引擎的檢索動作,抓取跟問題相關的網頁內容,再透過語言模型把這些內容理解、消化、統整成一段連貫的回答,過程中會判斷哪些來源的資訊比較可信、比較完整,優先納入回答的參考依據。這跟傳統搜尋引擎排名的邏輯有本質上的不同,傳統排名比較看重關鍵字密度、網站權重這類技術指標,ChatGPT在整理答案時,更看重內容能不能被清楚理解、資訊夠不夠完整、來源可不可信。也就是說,一篇文章就算關鍵字排名做得再好,如果內容東拼西湊、缺乏具體資訊,一樣很難被納入生成答案的參考來源。用我自己的話理解,傳統SEO像是在準備一場面試,重點是把履歷表包裝得吸引人;ChatGPT SEO更像是準備一場口試,考官會直接追問細節,答不出具體內容,就算履歷再漂亮也沒有用,這也是為什麼很多原本排名很好的網站,在AI搜尋的世界裡反而顯得吃力。
【LLM SEO跟傳統SEO、跟AEO差在哪裡】
這三個名詞常常被混著用,我簡單釐清一下彼此的關係。傳統SEO處理的是網頁在搜尋結果頁面的排名,目標是提高點擊率。LLM SEO是比較廣泛的說法,泛指針對各種大型語言模型,包含ChatGPT、Gemini、Claude等等,所做的能見度優化,範圍涵蓋內容結構、語意完整度、品牌可信度等面向。AEO則是Answer Engine Optimization的縮寫,中文常翻譯成答案引擎優化,比較聚焦在讓內容能夠直接、完整地回答使用者提出的具體問題,而不只是概略地涵蓋一個主題。三者其實是層層疊加的關係,把AEO的問答式內容邏輯,套用在LLM SEO要求的整體品牌可信度架構之上,再搭配傳統SEO打好的網站基礎,才是比較完整的做法,不需要糾結該優先做哪一個,而是理解各自負責的層面之後一起規劃。打個比方,傳統SEO像是把店面招牌做得夠醒目、動線規劃清楚;AEO像是訓練店員能針對顧客的每個具體問題,直接給出完整答案,而不是含糊帶過;LLM SEO則是確保不管顧客是在哪個平台問到你的店,得到的資訊都是一致、可信的。三件事分開來看各自獨立,但實際執行時,其實是同一套內容體質往不同方向延伸出來的結果。
【ChatGPT搜尋跟Google AI Overview的差異,實務操作要注意什麼】
雖然目標都是想被生成式AI引用,但ChatGPT搜尋跟Google AI Overview在技術層面有一些差異,實務操作時需要留意,如果只針對其中一個平台優化,很可能在另一個平台的能見度出現明顯落差。ChatGPT搜尋使用自己的網路爬蟲機制來檢索即時資訊,跟Google的搜尋索引系統不完全相同,這代表就算你的網站在Google排名很好,也不保證ChatGPT搜尋時就能順利檢索到你的內容,企業需要確認自己的網站沒有阻擋相關的爬蟲存取。另外,ChatGPT在呈現答案時,傾向給出結構化、條列式的整理,跟Google AI Overview的段落式摘要呈現方式也不太一樣,這代表內容如果本身就用清楚的條列或步驟方式撰寫,會比較容易被ChatGPT直接引用呈現的格式吸收。企業如果同時想兼顧兩個平台的能見度,內容架構上建議同時具備完整段落跟條列重點兩種呈現方式,讓不同的AI工具都容易解析,這種雙軌並行的寫法,前期會多花一些整理時間,但長期來看比較不會因為單押某個平台而錯失另一邊的曝光機會。
【想被ChatGPT引用,內容架構該怎麼設計】
實務上我會建議客戶用問答式的架構來規劃內容,具體來說可以拆成幾個步驟。第一步,先列出使用者針對這個主題最常提出的具體問題,這部分可以參考客服常見詢問、產業論壇的討論串,甚至直接問ChatGPT同樣的問題,看它目前是怎麼回答的,藉此找出資訊缺口,我通常會請客戶提供過去半年客服信箱或line官方帳號裡最常被問到的十個問題,這些真實的提問往往比自己憑空想像的關鍵字更準確。第二步,針對每個問題撰寫獨立、完整的回答段落,段落一開始就給出明確結論,再補充細節與依據,避免讀者需要看完整篇文章才知道答案。第三步,在文章裡明確交代作者背景、專業依據、實際案例數字,這些資訊會影響AI模型判斷內容可信度的結果,內容空泛或抄來抄去的文章,很難被當成優質引用來源,我看過不少企業的文章寫得很長,但整篇找不到一個具體數字或真實案例,這種內容即使排版再精美,對AEO也幫助有限。第四步,定期用不同的問法重新測試ChatGPT的回答內容,確認品牌是否有被提及,以及被提及時的描述方式是否正確,如果發現AI給出的資訊有誤,代表網路上關於品牌的正確資訊還不夠充足,需要加強補充,這個測試動作建議至少每季執行一次,才能掌握趨勢變化。
【技術面別忽略:讓AI爬蟲進得來,才有被引用的機會】
很多企業把心力都放在內容撰寫上,卻忽略了技術面的基本功。如果網站的robots.txt設定不當,誤擋了ChatGPT或其他AI工具的爬蟲,就算內容寫得再好,也完全沒有被檢索到的機會。另外,網站的載入速度、行動裝置的呈現效果、內容是不是需要登入才能瀏覽,這些都會影響AI爬蟲能不能順利存取並理解頁面內容。我實際遇過一個案例,客戶的網站因為資安考量,防火牆設定過於嚴格,連帶把幾個AI搜尋爬蟲也一併擋在外面,導致無論內容怎麼優化,品牌始終沒有出現在任何AI工具的回答裡,後來調整防火牆規則之後,才慢慢開始看到成效。我建議企業定期檢查網站的爬蟲存取紀錄,確認重要頁面沒有被誤擋,這是做LLM SEO跟AEO之前,最基本也最容易被忽略的一步,很多時候問題不在內容不夠好,而是內容根本沒被抓取到,花再多力氣寫文章都是白工。
以戰國策SEO/GEO服務這幾年協助客戶處理ChatGPT SEO與AEO優化的經驗來說,我們通常會先做一次技術面的健檢,確認網站沒有阻擋AI爬蟲存取,再回頭檢視內容是不是用問答式架構撰寫,這兩件事沒做好,後面投入再多內容產出的資源,效果都很難顯現。戰國策集團在數位行銷領域深耕超過二十六年,服務過的企業客戶累積超過三萬家,這幾年也持續把傳統SEO的操作經驗,延伸應用到LLM SEO跟AEO這類新的能見度戰場。
【常見問題】
Q:做ChatGPT SEO需要另外架設一個網站嗎?
A:不需要,重點在於既有網站的內容架構與技術可讀性調整,多數情況下可以在現有網站基礎上逐步優化,除非網站本身技術層面有嚴重問題,才需要考慮更大幅度的調整,貿然重新架站反而可能中斷既有的收錄紀錄。
Q:AEO答案引擎優化跟傳統的FAQ頁面有什麼不同?
A:概念上有相似之處,但AEO要求的完整度更高,傳統FAQ常常只給簡短答案,AEO則要求每個問答都要有足夠的細節、數據或案例支撐,讓內容本身具備被AI直接摘錄引用的完整性,而不只是列出問題清單應付形式,很多企業的FAQ頁面其實只是把常見問題條列出來,答案卻只有一兩句話,這種寫法對AEO的幫助非常有限。
Q:中小企業有辦法做好LLM SEO嗎?
A:可以,這件事跟企業規模沒有直接關係,重點在於內容有沒有清楚回答問題、有沒有可信的來源佐證,中小企業只要把內容基本功做扎實,一樣有機會被引用,甚至因為決策流程較短,調整速度反而可能比大型企業更快,不需要經過層層審核就能把內容調整方向定下來。
Q:多久可以看到品牌開始被ChatGPT提及?
A:跟傳統SEO類似,沒有固定的時間表,通常需要持續幾個月的內容優化與技術調整,建議定期用不同問法測試,觀察品牌被提及的頻率跟描述方式是否逐漸改善,而不是期待短時間內看到爆發性成長。
Q:LLM SEO跟AEO需要不同的團隊分開執行嗎?
A:不需要,兩者高度相關,建議由同一個團隊統籌規劃比較有效率。負責內容的人需要同時理解問答式架構的撰寫邏輯,以及品牌全網一致性的維護方式,拆成兩個團隊各自負責,反而容易出現內容跟品牌資訊對不上的狀況。
回到一開始那個晚上的疑問,後來我自己實際去查了那五家被ChatGPT點名的月子中心,發現它們的官網不約而同都有清楚的常見問題頁面、具體的收費說明、實際的環境介紹,資訊完整度明顯比同業高出一截,這也印證了ChatGPT SEO的核心邏輯,不是靠花俏的行銷手法,而是紮紮實實把資訊準備完整。我後來也拿同一個問題換了幾種問法再測試,發現只要問題描述得越具體,例如加上地區、預算範圍等條件,ChatGPT給出的答案就越穩定,重複測試好幾次都是同一批業者,這說明了資訊完整度累積到一定程度之後,確實會形成相對穩定的引用結果,而不是每次問都隨機亂跳。企業如果想在這場競賽裡卡到位置,越早開始整理資訊,越有機會在AI建立起穩定答案之前就被納入其中。如果你也想知道自己的網站在ChatGPT或其他AI工具眼中是不是一個容易被引用的來源,歡迎直接找我們聊聊,一起盤點現況、找出可以優先調整的方向,我們會依照實際測試結果,而不是憑感覺猜測,具體告訴你目前卡在哪個環節,下一步該怎麼調整比較有效率。
戰國策SEO/GEO服務
諮詢網站:hotels.com.tw
服務專線:0800-003-191
LINE ID:@119m
NVIDIA DLI 官方證書怎麼拿 ? 生成式 AI、LLM 應用開發完整攻略
想進入 AI 領域卻不知從何開始?NVIDIA Deep Learning Institute(DLI)官方認證課程為工程師、資料科學家和技術人員提供最實戰的學習路徑。課程涵蓋生成式 AI 開發、LLM 大型語言模型應用、異常偵測 AI、高效能運算 等熱門技術,透過雲端 GPU 實作環境,讓您邊學邊做,完成後且通過課後測驗即可獲得 NVIDIA DLI 官方頒發的完課證書,為履歷加分、提升職場競爭力!
🟡 NVIDIA DLI官方課程 - 使用提示詞打造 LLM應用服務
從 Prompt 編排、訊息策略、資料輸出到智慧代理設計,這門課程將是你邁向 LLM 開發的第一哩路,也是未來生成式 AI 應用不可或缺的核心技能。
Q: 誰適合這門課?
A: 具備 Python 程式設計經驗& 對 LLM 基礎知識有扎實理解
Q: 完成課程後,是否會提供相關證明?
A: 是的,在您完成所有課程內容且通過課後測驗後,將會獲得由 NVIDIA DLI 官方所頒發的正式完課證書。
▶️證照資訊 https://nabi.104.com.tw/ability/10049187
▶️課程資訊 https://nabi.104.com.tw/course/itcert/55c06dcd-98e6-4f89-be84-f1fa2b5fb4b8
【想更了解這堂課在上什麼先來聽聽開課說明會】https://nabi.104.com.tw/course/itcert/6ece6b5f-60b0-42eb-b7c8-5f0e170315a6
🟡 NVIDIA DLI官方課程 - 異常狀況偵測的AI應用
以電信產業網路入侵偵測為出發案例,實際操作三種核心異常偵測技術,結合理論、應用與效能評估,打造真正落地的異常預測能力。你將深入探索NVIDIA 加速運算平台上的 XGBoost 與深度學習模型,體驗其在高維資料處理與推論速度上的關鍵優勢,並理解監督式與非監督式技術在異常情境中的應用差異。
Q: 這門課程需要具備什麼樣的知識?
A: 為確保您能深入吸收課程內容,建議應具備:
1. Python 資料科學實務經驗
2. 對深度神經網路訓練原理的理解
▶️證照資訊 https://nabi.104.com.tw/ability/10049188
▶️課程資訊 https://nabi.104.com.tw/course/itcert/a36cfdb7-bd6d-4859-bd41-0c69c0237f02
NVIDIA DLI 課程能讓你親手操作 NVIDIA 最新技術,全面提升你在業界關鍵職位所需的實戰能力。
AI大神Karpathy的「LLM Wiki」是什麼?改善工作流、打造知識複利
AI大神卡帕西(Andrej Karpathy)是特斯拉Autopilot神經網路架構推手、OpenAI共同創辦人,看看他如何運用「LLM Wiki模式」蓋出知識圖書館,這個模式的核心主張是,維護結構化知識庫的初期成本,會在成熟後帶來巨大的回報。
文/樂羽嘉編譯 由天下雜誌授權轉載
本文目錄(點擊可快速前往)
LLM Wiki是什麼?卡帕西的真知灼見三層知識架構LLM Wiki核心主張:複利效應的豪賭LLM Wiki實際上怎麼運作?怎麼用Obsidian建立你的LLM Wiki?建立LLM wiki的訣竅LLM Wiki有哪些優點?LLM Wiki有哪些缺點?
每次問AI問題、得到答案,然後AI就失憶,下一次提問從零開始,是不是感覺很可惜?看看「AI大神」卡帕西怎麼幫AI蓋圖書館、累積知識複利。
每一位AI工程師都打造過類似的檢索流水線。你對文件做嵌入、切片、儲存向量,提問時回傳相關切片、由Claude或ChatGPT模型合成答案。
這套流程確實行得通,但如果3個月後有人問了一模一樣的的問題,系統只會機械式重複相同動作,沒有從前一次互動學習到任何東西。
這正是傳統RAG(檢索增強生成)的缺點,也就是從不保留知識。系統永遠處於健忘狀態,每一次查詢都必須從零開始,空有能力卻無法成長。
有AI大神之稱的卡帕西(Andrej Karpathy)是特斯拉Autopilot神經網路架構推手、OpenAI共同創辦人,透過課程教會一整個世代工程師深度學習。卡帕西發現這個問題,提出了一種架構上截然不同的處理方案──「LLM Wiki模式」。
「LLM Wiki」是什麼?為什麼重要?
LLM Wiki是什麼?卡帕西的真知灼見
卡帕西使用軟體工程學的「編譯」(Compilation)來做類比。
當你編寫原始碼時,編譯器會把原始碼轉換為優化的二進位產物。你不會每次都直接執行原始碼,你會編譯一次,分發產物,然後根據需求,有效率地跑原始碼。編譯過程雖然昂貴,但之後每次使用都能獲得回報。
傳統RAG直接針對原始碼去跑,每次查詢都要重新閱讀相同的論文、重新切分相同的PDF、重新綜合整理相同的答案,等於每次請求時都在執行原始碼。
LLM Wiki模式則主張:先編譯你的知識。使用LLM閱讀你的來源資料,把內容綜合整理為結構化、互連的wiki頁面,然後針對這個「編譯產物」做所有查詢。綜合整理過程只發生一次,隨著補充更多來源增加、更新,預先組織好而且經過交叉引用的知識則能改善每次查詢品質。
這個編譯產物是一個wiki。不是資料庫,不是向量資料庫,是一組人類可讀、由 LLM維護的markdown檔案,一個概念一個檔案,有交叉引用、來源追蹤,透過Git做版本管理。
這是核心觀念的轉變,從「無狀態的檢索」轉向「有狀態、有複利效應的知識」。
三層知識架構
卡帕西的模式把知識組織為3個界限清晰的層級,每一層都明確的定位、嚴格的所有權模型。
第一層:原始來源(不可變層)
這是你的輸入層。包括研究論文、YouTube逐字稿、網路文章、會議記錄、部落格文章,任何你想讓系統學習的文本。把來源文件存放在sources/目錄下,當成不可變(Immutable)處理。LLM會閱讀它們,但絕不會修改,這些文本是推導出後續所有內容的基礎真理。
這種不可變性是刻意設計,有需要的時候你隨時可以從零開始重新推導出整個Wiki。
第二層:Wiki(由LLM維護)
這是模式的核心。Wiki是一系列*.md檔案的集合,每個概念、主題或實體對應一個檔案,完全由LLM維護。人類閱讀Wiki,但不直接編寫,每次有新資料來源時,由LLM自動綜合整理、更新。
每個Wiki頁面都有YAML Front Matter(markdown檔案頂端存放後設資料的區域),用來追蹤標題、標籤、出處以及最後更新時間。頁面之間使用 [[slug]] 標記互相引用,使知識圖譜以純文本的形式清晰呈現。
第三層:schema(治理層)
schema是一個JSON檔案,定義整個頁面宇宙:Wiki追蹤哪些概念、它們的縮略名(Slugs)、標題、單行描述,等於是LLM執行人類意圖的合約。
當你希望系統開始追蹤一個新概念時,只要在schema中增加一個PageSpec(頁面規範)就好。下次吸收相關來源時,LLM就會自動建立、填寫這個頁面。若你想停止追蹤某個內容,就從schema拿掉。schema是人類唯一需要主動管理的部分,下游的一切都是自動化的。
也就是說,人類負責定義哪些知識應該存在,LLM則負責組織、整理這些知識並保持最新狀態。
LLM Wiki核心主張:複利效應的豪賭
LLM Wiki模式的核心主張是,維護結構化知識庫的初期成本,會在成熟後帶來巨大的回報。
傳統RAG避開了這些成本,查詢時才做綜合整理,建構成本低、不需要設計 schema,但永遠不會變聰明。第1天和第1000天的同一個查詢,產生的答案品質完全一樣。
LLM Wiki逆轉這種取捨。匯入成本高、schema設計費神、維護需要定期校對,但維護了一年的wiki與全新的系統的品質差異極大,頁面佈滿交叉引用,答案融合了數十個來源,這種複利循環代表有價值的答案本身也成為知識庫的一部分。
LLM Wiki實際上怎麼運作?
LLM Wiki架構很極簡,只有三個要素:
一個存放markdown檔案的資料夾:這就是你的知識庫,可以包含任何內容:研究筆記、會議摘要、專案文件、讀書筆記、個人參考資料、有附註的程式碼片段。
每個檔案內部要使用統一結構:好的LLM Wiki會使用一致的內部格式,包含標題、簡短摘要、主題標籤(Tags),接著才是內容。模型利用這種結構來更快速定位相關資訊。
用Claude Code當查詢介面:你打開終端機,切換到Wiki資料夾,啟動Claude Code,對它提問。Claude Code會讀取所需的檔案、合成答案,按照要求更新或新增筆記。
就這樣,不需要資料庫、不需要向量嵌入(你想要也可以加)、不需要伺服器。只有檔案和一個強大的模型。
Claude Code特別適合這項任務,因為它能直接從你的本地檔案系統讀取檔案。你不需要把內容複製貼上到聊天視窗,只要告訴它筆記在哪裡、直接提問就可以了。
怎麼用Obsidian建立你的LLM Wiki?
你可以使用Obsidian這個本地優先markdown編輯器,來建立工作流。你的檔案都保存在本機硬碟中,Obsidian只是用來讀寫這些檔案的工具。
第一步:安裝Obsidian、建立vault(資料庫)
從官方網站下載 Obsidian,建立新的vault,放在你容易記得的位置,例如~/wiki或~/Documents/llm-wiki。
在Obsidian中,「vault」只是一個資料夾,裡面全部都是純markdown檔案。
第二步:定義筆記模板
一致性是讓wiki可查詢的關鍵。建立一個模板檔案_templates/note.md:
Markdown
# undefined
**Summary**: 用一句話描述這則筆記**Tags**: #topic1 #topic2**Created**: 2026-04-06T00:00:00+00:00**Last Updated**: 2026-04-06T00:00:00+00:00
---
## Content
在這裡寫主要內容
## Related Notes
- [[Note Title]]
不需要完全照這個格式,重點是每篇筆記都要有一行摘要(Summary)、標籤(Tags),這樣Claude就算完全不讀整個檔案,也能快速判斷相關性。
第三步:用大分類資料夾整理
不要過度設計,先從4到5個頂層資料夾開始:
plaintext
Copywiki/├── _templates/├── projects/├── research/├── reference/├── meetings/└── inbox/
inbox/ 用來放還沒整理的筆記,之後讓Claude幫你分類。
第四步:開始寫第一批筆記
把對你最重要的知識先搬進來,例如常查的資料、整理好的流程、研究過的概念、做過的決策與這樣做決策的原因,不要一次全部匯入,最自然的方式是遇到新資訊就慢慢加入。
第五步:安裝Claude Code
先安裝Node.js,然後執行:
Bash
npm install -g @anthropic-ai/claude-code
登入你的Anthropic帳號後就可以使用。
第六步:查詢你的Wiki
打開終端機,進入你的wiki資料夾:
Bash
cd ~/wikiclaude
然後可以問問題,像是:
我有哪些關於機器學習的筆記?幫我整理research資料夾中關於RAG系統的內容我要寫關於X的提案,有哪些相關筆記?找出提到雨傘公司的筆記、摘要關鍵論點
Claude會讀取你的markdown檔案,找出相關內容,給出有依據的回答,標註來源檔案,讓你可以驗證、深入挖掘。
建立LLM wiki的訣竅
寫摘要,不要只寫內容:每篇筆記開頭的一句摘要非常重要。Claude會先看這一行來判斷是否相關,花個10秒寫摘要,可以省掉模型讀錯文件的成本。
使用一致的術語:例如你有時寫「RAG」、有時寫「retrieval augmented generation」,模型可以理解,但是統一用詞會讓結果更乾淨。
建立筆記之間的連結:Obsidian的 [[wiki link]] 會建立筆記之間的關係,Claude可以沿著這些連結推理。連結愈完整,你的知識系譜就愈強。
筆記要聚焦:比起餵一篇1萬字的大雜燴,不如拆成10篇1千字的主題筆記。內容愈聚焦,愈好查詢。
使用 /inbox 蒐集想法:不一定要追求完美,你可以把粗略、雜亂的筆記丟進 /inbox,再請Claude幫你整理,例如「幫我看inbox資料夾,建議每篇筆記該分類到哪裡,並加上標籤」。
LLM Wiki有哪些優點?
知識會隨著時間累積產生複利。這是核心優勢,每一份資料都會豐富同一個Wiki頁面,改善後續的所有查詢。一個匯入50篇關於Transformer論文的Wiki,在回答相關問題時,回答的深度和交叉引用的密度,會遠超過只對同樣 50篇論文進行切片的RAG系統。Wiki的答案整合全貌,RAG則只會翻出最相似的切片。
Wiki變成熟後,查詢速度變快、變便宜。由於「綜合整理」發生在匯入階段而不是查詢階段,查詢過程就變成了針對預先組織好的材料進行「檢索+生成」,那些吃力的LLM工作都已經事先做好了,包括理解來源、識別重點、撰寫清晰解釋、建立關聯。
人類能閱讀知識庫。所有的產物都是純markdown檔案,工程師可以閱讀、編輯、對Wiki進行版本管理。如果LLM寫錯了,你可以直接修正。Git歷史紀錄提供了完整的稽核軌跡,沒有難以除錯的不透明嵌入資料庫或向量儲存。
出處明確。每個wiki頁面都會記錄哪些來源文件有貢獻。如果一個頁面包含錯誤資訊,你可以追溯回原始來源。當某個來源更新或被證實不可信時,你清楚知道哪些頁面需要重新匯入資料。
規模運作提高成本效率。在重複的綜合整理調用中,系統提示詞的快取機制能大幅降低API成本,路由機制能防止不必要的頁面重寫。成本高昂的綜合整理工作已經在匯入時預先完成,所以每次查詢的成本非常低。
交叉引用的密度。隨著wiki持續擴充,頁面會累積用 [[slug] 形式指向相關概念的交叉連結,這就是用純文字實現的知識圖譜。wiki發展成熟後,這種可導航的知識結構對查詢很有幫助。
LLM Wiki有哪些缺點?
大規模資料匯入緩慢、昂貴。對於每個來源,流程至少會對每個相關頁面呼叫兩次Claude(路由+綜合整理)。若匯入一個包含50篇論文、產出10個wiki頁面的語料庫,呼叫Claude API的次數約是100到200次。這對個人知識庫可行,但對企業級的大規模匯入流程來說成本較高。這個模式是適合最佳化精心挑選的可策展知識,比較不適合用來大量匯入文件。
綜合整理的品質很依賴LLM。wiki的品質取決於用來整理內容的模型,如果模型誤解來源、錯誤地合併兩個概念、憑空產生不存在的關聯(幻覺),這些錯誤會寫進wiki,持續影響後續所有查詢。所以這一步需要仔細設計提示詞、定期執行deep lint檢查。
schema設計是一種負擔。決定要建立哪些頁面、如何命名、描述範圍怎麼界定都不簡單。設計不良的schema會導致:什麼都被判定為相關或什麼都抓不到,產生過於稀疏或過度膨脹的頁面。在新領域中,通常需要反覆迭代才能設計出好的schema。
線性掃描限制規模。使用NumPy計算餘弦相似度的扁平化嵌入索引,在頁數達到約500頁以前都很有效。超過這個規模後,延遲會惡化,需要引入近似最近鄰(ANN)索引工具(如 FAISS、ChromaDB或Weaviate)。若要擴展至混合檢索(BM25+向量檢索),則需要額外成本。
頁面過時風險。當你加入一個會大幅更新某個概念的新來源時,路由步驟應該要捕捉到、觸發「重新合成」,但如果頁面的schema描述太模糊或對齊不良,負責路由的LLM可能無法看出相關性,導致該頁面內容過時。雖然可以透過定期檢查程式碼或定期全面重新匯入來減少問題,還是需要主動維護。
缺乏即時知識。這個模式不是為了即時串流數據(如X推文、股市數據、新聞API)設計的,對於需要即時更新的知識領域,wiki模式反而會增加摩擦而非提升效率。
(資料來源:Medium、MindStudio)
(原文標題:AI大神教你改善工作流,用「LLM Wiki」打造知識複利)
推薦閱讀:
用AI做競品分析如何開始?7步驟看懂對手弱點,制定攻防策略
最新模型Gemini 3.1 Pro 7個「深度工作」必備提示詞
專家:但願你能早點知道的8個ChatGPT好用方法
比提示工程更重要,「上下文工程」Context Engineering怎麼做?
[稽核]如何在使用LLM等大語言模型工具時保持機密性?
稽核工作中非常重要的事情就是機密性
稽核常常需要接觸到公司許多機密的資料
要保持機密性不可洩漏是非常重要的事情
但在AI時代我們常常會使用網路上的AI工具
在使用這些AI工具時一定得非常小心,不能上傳公司資料或透漏消息
所以在與大型語言模型對話時,要把機密、個資等等資訊刪除
另外也建議要關閉大型語言模型儲存我們對話的數據來訓練資料
以下是關閉目前比較常用的幾項大語言模型儲存數據的方式分享給大家
一、OpenAI的ChatGPT
1. 首先點選右上角頭像後點選「設定」
2. 點選「資料控管」,將「為所有人改善模型」的選項關閉
3. 裡面也有一些隱私權政策,可以稍微閱讀一下確定自己可以接受再使用哦!
二、Google的Gemini
1. 點選左下角的「活動紀錄」
2. 將「儲存活動」的選項關閉,並且可以刪除過去的對話
3. Google在https://support.google.com/gemini/answer/13594961?hl=zh-Hant中的「調整設定」有提到:
如果不希望我們審查日後對話或將其用於改良 Google 機器學習技術,[請關閉 Gemini 系列應用程式活動記錄](https://support.google.com/gemini?p=pause_activity&sjid=12318481658026104633-NC)。如要查看 Gemini 系列應用程式活動記錄中的提示,或刪除對話內容,請前往 [myactivity.google.com/product/gemini](https://myactivity.google.com/product/gemini)。
三、Anthropic的Claude
1. Claude有提到不會使用對話來訓練模型
2. 直接問Claude他也有相關回應
總的來說,在使用AI工具、大型語言模型時一定要注意資訊安全及保密原則
就算有聲明不會儲存數據用來訓練,還是可能會有人工審查,同樣存在機密外洩的風險
尤其身為稽核人員更是需要注意
Notion完整文章連結:https://stevenwublog.notion.site/LLM-19ff7f8f282880d387d3e6bed607207f

AI助攻學習大躍進,開啟英語學習新時代!
隨著全球化與AI技術快速發展,臺灣的英語學習環境正經歷重大轉變,各種線上學習工具與資源不斷推陳出新。為提升國人英語能力,財團法人語言訓練測驗中心(LTTC)與國家發展委員會(簡稱國發會)合作推出新的英語學習平台,希望能成為學習者的有力輔助工具。
本文導覽
國際人才磁鐵,英語力是關鍵結合AI技術,打造智能學習評量系統全方位學習體驗:聽讀說寫全面提升第一線使用者回饋:有效提升學習效率AI學習工具的未來發展
國際人才磁鐵,英語力是關鍵
在全球化浪潮下,臺灣面臨的人才競爭愈發嚴峻,加上少子化的衝擊,如何吸引並留住國際人才,已成為國家發展的重要課題。國發會綜合規劃處林麗貞處長指出,想要讓國際人才願意在臺灣長期發展,就必須讓他們在日常生活中溝通無礙,而提升全民英語能力正是關鍵因素,這也符合政府推動的雙語政策目標。
延伸閱讀:職場「英語力」是提升競爭力的關鍵,自主學習外更需專業助攻!
結合AI技術,打造智能學習評量系統
因此LTTC及國發會集結了語言測驗、教育與科技領域的專家,共同研發「全民英檢i學網」(GEPT iPrep)英語學習平台,以提供更符合臺灣學習者需求的工具。LTTC執行長李欣穎指出,該平台運用全民英檢25年來累積的考生應答數據與歷年試題資料庫,透過AI技術進行學習診斷與評量,使其更貼合本土學習者的需求。
LTTC副執行長吳若蕙補充說,透過AI技術,學習者可以透過標準化的測驗與即時回饋來了解自己的強弱項。這不僅能幫助教師在教學時提供更精準的指導,也能讓自學者更有效率地提升英語能力。她強調,AI的角色是輔助學習,而非取代真人教學,「人機協作」才是最佳學習模式。
◆ 全民英檢,求職加分最佳利器▶ 點我報名◆ 全民英檢備考課程,專業師資指點迷津▶ 點我報名◆ 全民英檢i學網,AI評分即時回饋▶ 點我練習
全方位學習體驗:聽讀說寫全面提升
長期以來,臺灣的英語學習者在口說與寫作的練習機會較少,尤其缺乏系統化的評量工具,使得學習者難以掌握自身的進步情況。此新學習平台提供完整的聽、說、讀、寫四大類練習,並透過AI分析學習者的表現,提供個人化回饋。例如,聽力與閱讀的評量包含能力指標、未精熟單字、文法與學習建議,而口說與寫作部分則提供語音與語法分析,幫助學習者針對弱點進行改善。
十二年國教英語科召集人張武昌教授表示,英語學習是一個持續累積的過程,不應只侷限於學校課程,而應該讓所有學習者都能獲得適合自己的學習資源。他強調,從紙本教材到線上學習工具的發展,都是為了幫助臺灣整體英語實力的提升,使國人能更順利地融入國際環境。
第一線使用者回饋:有效提升學習效率
曾在英語補教業工作的張小姐分享,過去學生在口說與寫作方面的進步往往仰賴與教師的互動或適合的學習環境,但這樣的機會有限。透過AI評量系統,學生即使在學校或補習班之外,也能隨時進行練習並獲得回饋,大幅提升學習自主性。
就讀臺大藥學系的洪同學也表示,這樣的學習平台讓他在口說與寫作的表達更加精準。AI不僅能協助刪除冗詞贅字,還能提供更自然、實用的語句建議,讓學習者能夠針對自身的表達進行微調。他認為,這比單純讓AI重寫一篇文章來得更有意義,因為能夠幫助使用者理解自己的錯誤並加以改進。
AI學習工具的未來發展
隨著科技進步,英語學習方式也在不斷演進。「全民英檢i學網」已於2025年1月開放全民使用,但仍持續優化中,期望未來能提供更精準的學習診斷與回饋機制,透過結合AI的個人化學習體驗,讓學習者更精準地掌握自身的學習狀況,並針對弱點進行強化。這不僅有助於提升臺灣的英語能力,更能讓學習者在國際舞台上發揮更大的競爭力。
★ 全民英檢i學網:https://prep.gept.org.tw
[joblist_plugin title='【全民英檢】讓求職競爭力更高!' url='https://www.104.com.tw/jobs/search/?jobsource=joblist_search&keyword=%E5%85%A8%E6%B0%91%E8%8B%B1%E6%AA%A2&mode=s&page=1&order=15&asc=0&searchJobs=1&sctp=M&scmin=50000&scstrict=1' amount='5']
強化語言能力,是提升職場競爭力的關鍵!
職場「英語力」是提升競爭力的關鍵,自主學習外更需專業助攻!
想進外商公司英文要多好?3件比考英文檢定更重要的事
學外語還是買股票有「錢」途?史蒂夫和戴夫告訴你
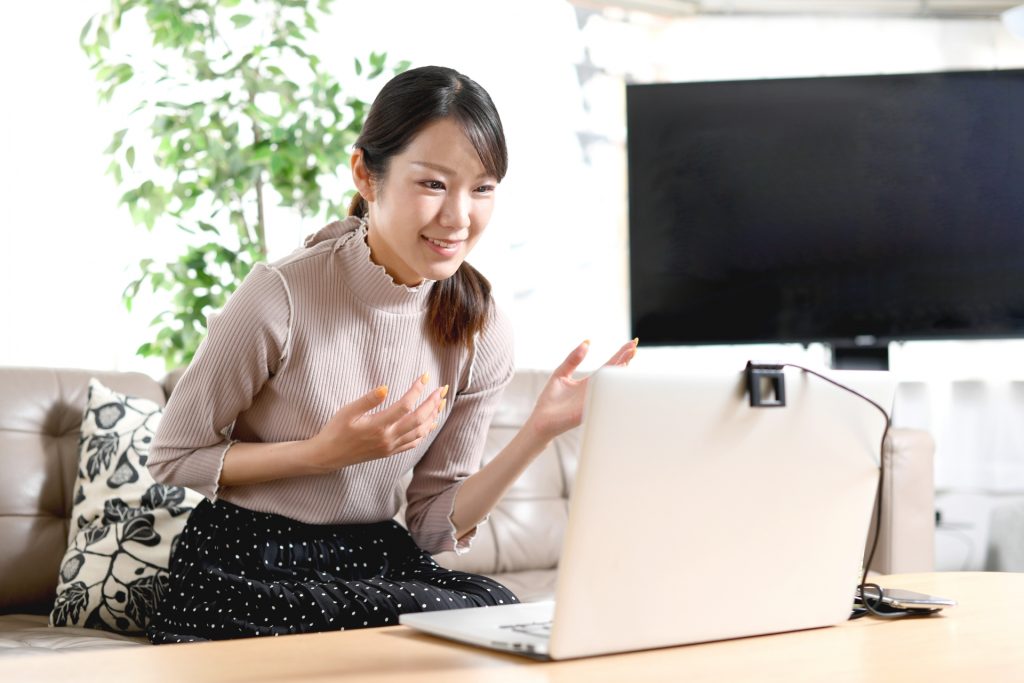
從傳統化工走向科學公司:李長榮讓不同專業走進半導體材料
文/104人力銀行
本文導覽:
從傳統石化跨向先進材料,人才也不再只有單一面貌
做出一項新材料,不能只有技術,也要理解市場與客戶
AI成為跨域學習的工具,但答案仍需人的判斷
新時代的稽核——從財務數字走進企業營運
在快速變動的材料產業,持續改善比什麼都會更重要
從化學、材料到電機,理工人才都能找到切入點
把一項技術做成產品,是最有挑戰,也最好玩的事
從技術深化到跨部門移動,職涯不會只有一個方向
從一項專業出發,走進更完整的半導體材料產業
走過將近一甲子的李長榮,並未停留在外界熟悉的基礎石化與傳統化工領域,而是在一次次轉型中,持續拓展技術邊界與產業角色。
從特用化學品、高值化材料,到電子材料與半導體應用,李長榮在拓展產品線的同時,也從一家化工企業,走向以「重新想像科學」為方向的科學公司。
在半導體供應鏈中,材料是支撐製程運作的重要基礎。即使材料不會成為消費者直接看見的終端產品,仍可能影響新製程能否開發、產品能否量產,以及供應鏈能否穩定運作。
一項新材料從技術構想到實際產品,並非只依靠單一專業完成。前端需要研發人員探索材料特性、製程方法與應用可能;後端則需要製造、品質、業務,以及掌握成本、流程與營運風險的財會與稽核團隊,共同確保技術能夠穩定落地。
因此,半導體材料產業所需要的人才,也不只有傳統認知中的理工背景。從科學技術中心的研發人員,到商管、財會與風險管理專業的人才,都在企業從技術創新走向市場應用的過程中,扮演不可或缺的角色。
不同專業各自擁有不同視角,也必須在合作中理解彼此的工作語言,讓一項材料從實驗室、工廠,最終走向產業應用。
從傳統石化跨向先進材料,人才也不再只有單一面貌
李長榮科學技術中心專案管理課課長謝承廷觀察,李長榮過去較容易被理解為石化企業,近年則跨足特用材料、高值化材料與半導體應用,並將事業版圖延伸至先進材料領域。
企業的技術與市場範圍持續擴大,也讓研發工作不再只停留在技術本身。謝承廷指出,技術人員除了具備材料、化學與製程知識,也要認識客戶需求、產業發展、產品成本與商業模式,才能將技術轉化為可被應用的產品。
跨域並不代表進入公司前就必須樣樣精通,而是先具備一項紮實的專業,再從專案與跨部門合作中,補足不熟悉的市場、財務或商業知識。
從稽核工作的角度來看,跨域則有另一種意義。李長榮稽核室經理林育丞表示,稽核人才仍以商管、財會、內控與風險管理知識為根基,但若只看報表與數字,便難以判斷實際營運流程中的風險。
稽核人員必須認識產品如何被研發與製造,也要掌握原料採購、產品訂價與銷售方式,進而將財務數字與第一線的生產及營運流程連結起來。
因此,李長榮看重的,並不是每個人都具備相同能力。研發人員以技術為核心,延伸對市場與成本的認識;稽核及財會人才則從數字與流程走進產品、工廠與實際營運。
做出一項新材料,不能只有技術,也要理解市場與客戶
研發的起點,通常是一個尚未有明確答案的問題。
研究人員可能熟悉某一項化學合成、材料特性或製造方法,但要讓技術真正成為產品,還要理解客戶痛點、市場方向、產品成本,以及實際的應用場景。
對剛完成博士訓練的研發人才而言,進入企業後,還得培養課堂之外的能力,例如拜訪客戶、辨識需求、說明技術,以及將研究成果轉化為客戶能夠理解並願意採用的產品。
謝承廷指出,研究人員不能只把技術做出來,也必須學會「把技術說得讓別人聽懂」。從技術是否可行,到產品成本、潛在客戶及應用市場是否成立,都仰賴研發、業務、財務、製造與其他支援單位共同判斷。
科學技術中心除了推動既有的新產品專案,也鼓勵同仁提出前瞻構想與小型計畫。員工可以從觀察到的產業問題發想,並在內部共創平台上,與不同專業的同仁交流。一個剛提出的概念,可能面臨材料選擇、成本或市場需求等質疑,卻也能在討論與修正中,形成更完整的產品方向。
AI成為跨域學習的工具,但答案仍需人的判斷
謝承廷表示,科學技術中心長期累積技術文件、研究報告、專利、工廠數據與產業資訊,並與AI團隊合作,將資料建置於符合資安規範的內部平台,供員工搜尋與整合。
對研發人員而言,AI可以協助補足不熟悉的領域,但使用者仍須具備核心專業與清楚目標,懂得提出問題,也能質疑並驗證AI提供的內容。
這項原則同樣適用於稽核。林育丞指出,公司鼓勵同仁運用資料分析、統計軟體與AI工具,從大量資訊中尋找異常與風險;企業的重要交易與營運資料,則必須留在公司可控的系統環境中,避免敏感資訊流向外部平台。
AI可以提高資料處理效率,真正決定分析方向的仍是人的邏輯。稽核人員應先釐清問題,再進行資料清洗、交叉分析與查證,讓數據呈現實際情況。
新時代的稽核——從財務數字走進企業營運
傳統印象中的稽核,經常被理解為檢查帳目、翻閱憑證,或找出不符合標準的地方。然而,在一家橫跨石化、材料、製造與海外市場的企業中,稽核所處理的,早已不侷限於財務報表上的數字。
林育丞表示,稽核人員要了解公司的採購、銷售、研發與生產流程,包括產品如何被製造、如何訂價,以及不同市場為何形成不同的銷售方式。掌握完整流程,才能辨認風險可能出現的位置,以及哪些環節需調整。
「每一次查核,其實都是在了解別人的日常。」林育丞形容,新人進入公司後,也要實際走進工廠,認識產品種類、製造方式、採購、銷售及合約流程。與現場人員交流,也讓報表上的數字得以連結到第一線面對的問題。
他強調,稽核並不是站在對立面尋找錯誤,而是從公司整體利益出發,協助組織看清風險並持續改善。
完成稽核報告也不代表工作就此結束。當發現異常時,稽核人員必須向受查單位說明問題及其可能造成的影響,再提出具體建議,持續追蹤至改善完成。因此,稽核除了重視獨立、客觀與誠信,也看重溝通與協作能力。
在快速變動的材料產業,持續改善比什麼都會更重要
電子材料與半導體應用的產品週期短,市場及客戶需求也變動得更快。面對這樣的環境,公司除了看重專業能力,也重視人才是否願意持續成長。
謝承廷表示,安全是所有工作的基礎;在此之上,人才還要具備持續改善的能力。沒有人能在進入公司時便掌握所有知識,而是要在不同職涯階段,持續從客戶、同事與合作夥伴身上學習。
新材料的開發週期漫長,過程中也會遇到未知問題。對研發人才而言,好奇心、技術熱情與探索知識的意願,重要性並不亞於既有實力。
林育丞也指出,對稽核與商管人才來說,好奇心同樣重要。面對雜亂的數據與陌生流程,必須願意多問、多交流,才能真正理解企業如何運作。
無論研發或稽核,公司看重的都不是特定的外向或內向人格,而是在既有專業之外,願意認識不同領域、解決問題,並與其他部門合作的心態。
從化學、材料到電機,理工人才都能找到切入點
目前科學技術相關職務仍以化學、化工與材料背景為主要需求。隨著產品與技術範圍擴大,高分子、半導體與電機等理工人才,也能從各自專業找到切入點。
謝承廷表示,公司重視的是求職者能否設計實驗、建立技術方法,以及面對問題時找出解法。理工領域雖各有不同,每個人仍能運用原有專業,延伸至材料與半導體應用。
稽核相關職務則以商管、財會、內控與稽核背景為主,也重視數據分析能力。除了過去常用的 Power BI,統計軟體與 AI 工具,也逐漸成為工作中重要的輔助工具。
英語也是跨國企業與電子材料工作的重要基礎。無論是研發人員閱讀國際文獻與專利,或稽核人員前往海外事業體執行查核,都要具備英文溝通及理解能力;日語則可成為額外加分條件。
把一項技術做成產品,是最有挑戰,也最好玩的事
謝承廷觀察,許多新進研發人員具有博士背景,對特定技術或研究方向相當熟悉;但要真正做出一項產品,還得學會拜訪客戶、掌握市場變化,並認識成本與商業模式。
「後面要補齊的東西其實很多,但這也是最有挑戰性、同時最好玩的地方。」謝承廷表示,當一個人能把技術、市場、客戶與成本連結起來,最後從零做出一項產品,過程中的挑戰也會成為持續投入的熱情來源。
研發工作的終點不在於完成技術,而是讓技術真正走向市場。除了開發產品,還要讓客戶理解它解決了什麼問題,以及這項技術為何值得採用。
稽核工作的挑戰則是必須在短時間內掌握陌生流程。林育丞指出,稽核人員一年中會接觸許多不同專案,得結合訪談溝通、流程文件、現場觀察與AI工具,迅速掌握工作運作方式,再判斷其中可能存在的風險。
真正的異常未必會直接出現在文件上,而要經過大量資料清洗與交叉分析,才可能被看見。即使找到問題,仍須有邏輯地向受查單位說明問題所在與改善的必要性。
從技術深化到跨部門移動,職涯不會只有一個方向
喜歡深入研究技術的人,可以朝科學家與技術專家的路徑前進;希望拓展工作範圍的人,則能成為專案或產品負責人,進一步走向行銷、製造與管理職務。
謝承廷表示,也有人從研發轉向產品、專案、製造、行銷或海外事業。公司安排研發人員參與跨國會議、學術交流與海外展覽,並與國內外學者及產業專家互動,接觸不同領域的技術趨勢。
對稽核人員而言,跨國工作也不是將台灣既有的查核方式搬到海外。林育丞指出,前往不同國家執行查核時,必須認識當地法規、市場結構、組織文化與工作習慣,才能提出符合當地情境的內控與改善建議。
從一項專業出發,走進更完整的半導體材料產業
對年輕人才而言,加入今天的李長榮,所接觸的已不只是傳統化工。從半導體材料、研發創新、數位稽核到國際市場,李長榮正從以化學為核心的企業,走向涵蓋材料、製程、數據與市場應用的科學公司。
材料是半導體產業的基石。要讓一項新材料真正走向市場,除了實驗室裡的研究人員,也仰賴掌握客戶需求、品質與成本的團隊,以及能從全貌辨認風險與機會的人才。
當企業持續重新想像科學,人才也不必只沿著既有職稱與科系前進。以自身專業為起點,學習另一種工作語言、認識另一個部門,甚至走向另一個市場,或許正是非典型半導體產業中,最值得被看見的職涯價值。
免費報名【台積電供應鏈】聯合徵才
歡迎所有求職者踴躍參由台積公司主辦_半導體基礎技術人才博覽會,除了現場與企業面對面媒合交流,還有免費履歷健診及職涯探索,另外出席即獲加碼抽獎資格,手機、耳機等大獎等你來抱回!立即報名⭢https://104ad.pse.is/9g7tpa
想進半導體供應鏈?再看看這些職涯機會:
從反覆送樣到正式量產:新應材如何讓台灣材料進入半導體製程
整合藏在建築裡的百餘種管線,撐起半導體良率的隱形系統——專訪洋基工程
營造蓋的不是工廠,是半導體起跑的第一秒:麗明營造在高壓工地,養出能扛數十億專案的人才
Meta 首款模型 Muse Spark Meta AI App 及 Meta.AI 網頁全面升級
2026-04-09 經濟日報記者彭慧明 由聯合新聞網授權轉載
Meta宣布,正式推出全新語言模型Muse Spark,是Meta Superintelligence Labs打造全新系列的大型語言模型中的第一個模型。
Muse Spark是Meta專為旗下產品量身打造的全新模型,也是迄今最強大的模型,有效提升Meta AI的效能及反應速度。目前已導入Meta AI App及Meta.AI網頁,支援進階邏輯推理與多模態任務處理。並預計於未來幾週內,陸續推展至Facebook、Instagram、Messenger、WhatsApp與AI眼鏡中。Meta也將透過API限定開放模式,提供給特定合作夥伴搶先體驗。
Meta在Muse Spark中導入強大的多模態感知能力,與其他AI需仰賴用戶逐一輸入描述不同,Meta AI不只能讀懂使用者輸入的文字,更能直接看見並理解大眾提供的視覺資訊。
例如,只要拍下機場零食架的照片,Meta AI就能辨識並排序出蛋白質含量最高的零食,無須費力查看營養標示,只要直接掃描商品,即可快速了解不同零食的成分差異。Meta AI應用於AI眼鏡時,AI助理將更清楚掌握並理解周遭環境。
健康資訊是大眾使用 AI 的主要需求之一,Meta AI透過Muse Spark的多模態感知能力,將可評估不同情境的影像與圖表,提供更細緻的回覆。Meta AI攜手臨床醫師專團隊,提升模型在常見的健康相關問題上,提供健康與醫療領域相關資訊,回應協助大家理解與健康有關的疑慮。
Muse Spark也擅長視覺化程式開發(visual coding),只需要輸入提示詞,就能建立客製化網站與小遊戲。未來可以請Meta AI製作一個用來規劃驚喜派對的儀表板、快速生成一款復古街機遊戲邀請朋友一起挑戰,或推出一個充滿想像的飛行模擬器,並將這些遊戲內容分享給朋友。
NotebookLM 八大強大功能!節省80%資料處理時間
當AI從趨勢變為職場標配,懂得駕馭AI工具將是拉開專業差距的關鍵。Google推出的NotebookLM正是一款重新定義資料分析與知識管理的強大應用。本文將揭示NotebookLM的八大核心功能,從語音摘要到一鍵生成簡報,展示它如何不僅提升個人生產力,更能優化團隊協作與知識庫建立。這不只是一次工具教學,更是幫助您在AI時代保持領先競爭力的實戰指南。
文/人資市集
前言
在資訊爆炸的時代,我們經常面臨需要閱讀、分析和整理大量文檔或資料的狀況。無論是上百頁的研究報告、冗長的會議記錄,還是複雜的產品說明書,這些文檔往往成為工作中的一大痛點。相信大家都有為了要快速掌握大量資料而感到壓力山大,或者花費數小時整理會議記錄卻仍覺得效率低下,難以抓到重點!
Google推出的NotebookLM,正是為解決這些問題而生。這款強大的文檔分析工具能夠幫助你在短短幾分鐘內完成過去需要數小時甚至數天才能完成的文檔處理工作,讓你的工作效率提升到一個全新的層次。
文檔處理的挑戰及痛點:
資訊超載:需要閱讀和理解大量文檔,但時間有限
語言障礙:面對外語文檔時感到吃力
會議記錄負擔:花費大量時間整理會議紀要
資料整合困難:難以從多個來源提取和整合關鍵資訊
簡報製作耗時:需要花費大量時間將資料轉化為專業簡報
知識管理混亂:團隊間的知識共享和管理效率低下
真實應用案例:從455頁報告到完整分析只需幾分鐘
想像一下,你的客戶剛發來一份455頁的英文研究報告,希望你能在明天的會議前提供分析和建議。傳統做法可能需要你熬夜閱讀,或者乾脆放棄深入分析。
使用NotebookLM,你只需:
上傳PDF文件
等待系統自動分析(通常只需1-2分鐘)
直接向AI提問你感興趣的特定領域,如「請整理報告中關於食品行業的AI應用」
系統會立即從這455頁的文檔中提取相關內容,並以結構化的方式呈現給你,同時提供引用來源,確保資訊的準確性。你可以進一步要求系統生成簡報、心智圖或資訊圖表,幫助你在會議中清晰地展示這些發現。
最重要的是,NotebookLM會在每個回答後標明資訊來源,你可以點擊查看原文,完全避免了AI"幻覺"(無中生有)的問題,確保你的分析建立在真實資料上。
會議記錄的革命:從錄音到完整會議摘要
另一個常見痛點是會議記錄。傳統上,我們需要:
錄製會議
使用逐字稿軟件轉換成文字(通常需要付費)
手動整理成會議紀要
使用NotebookLM,這個過程被大大簡化:
上傳會議錄音(支持長達1.5小時的音檔)或YouTube連結
系統自動生成逐字稿
要求AI「製作會議記錄」
幾秒鐘內獲得結構化的會議整理,包含100字摘要、討論重點、結論和未來規劃建議
這不僅節省了大量時間,還確保了會議記錄的完整性和專業性。
NotebookLM的八大強大功能
NotebookLM不僅僅是一個文檔分析工具,它還提供了豐富的輸出形式,滿足不同場景的需求:
語音摘要:將文檔轉化為Podcast形式,讓你在通勤或運動時也能吸收知識
影片摘要:自動生成解說影片,以視覺化方式呈現文檔內容
心智圖:快速掌握文檔的核心脈絡和框架
報告:生成專業的報告文件,支持多種格式和語言
學習卡:將文檔內容轉化為互動式學習卡,幫助記憶和理解
測驗:自動生成選擇題,測試對文檔內容的掌握程度
資訊圖表:將數據和概念轉化為直觀的視覺圖表
簡報:一鍵生成專業簡報,省去設計和排版的時間
這些功能讓NotebookLM成為一個真正的一站式文檔處理中心,無論你需要什麼形式的輸出,都能輕鬆實現。
知識管理與團隊協作的得力助手
NotebookLM不僅適用於個人使用,還是團隊協作的理想工具:
每個免費帳號可建立100本筆記本,每本筆記本可放置多個文檔
支持筆記本共享,團隊成員可以訪問同一資源
所有筆記和生成內容都可以保存,形成知識庫
適合專案管理,所有相關文檔和討論都集中在一處
這使得NotebookLM成為企業知識管理的理想選擇,幫助團隊更高效地共享資訊和協作。
生活應用:家庭電子設備說明書管理
除了工作場景,NotebookLM在日常生活中也有實用價值。例如,你可以創建一個家庭電子設備說明書筆記本:
收集家中所有電子設備的說明書PDF
上傳到同一個NotebookLM筆記本
當設備出現問題時(如除濕機紅燈閃爍),直接向AI提問
立即獲得準確解答,無需翻閱厚重的說明書
這種應用大大簡化了家庭設備的維護和故障排除。
為什麼現在就應該學習NotebookLM?
隨著AI技術的快速發展,掌握NotebookLM不僅能提高個人工作效率,還能在職場中獲得競爭優勢:
節省80%的文檔處理時間:將原本需要數小時的工作縮短至幾分鐘
提升內容質量:生成專業的報告、簡報和圖表
增強知識管理:更有效地組織和共享團隊知識
降低語言障礙:輕鬆處理外語文檔
最重要的是,NotebookLM的許多高級功能(如資訊圖表、簡報)目前正處於Beta測試階段,免費提供使用,現在學習和使用是最佳時機。
不要讓文檔處理繼續成為你工作中的負擔。立即加入「AI超效文檔助手-NotebookLM × Gamma × Napkin 全攻略」這門課程學習,手把手掌握NotebookLM的全面應用,讓你的工作效率和成果品質都能提升到一個新的高度。
企業用戶歡迎申請課程免費試閱,並選擇「104人資市集 | 企業訂閱制方案」,課程每人每年最低33元起/堂,最低$10,000起搞定全公司整年度的AI導入培訓。亦可團購或授權課程,歡迎點擊下方專人諮詢。
免費試閱
了解方案
專人諮詢
提升員工帶動企業的成長!最划算的 AI 教育訓練方案首選>>
超過7000+的HR都報名過的104人資學程!求職成效提升至4.5倍!>>
成為人資市集Line好友獲得最新課程優惠及免費講座資訊>>
訂閱人資市集電子報獲得專家工作分享及產業新知 >>
亞洲大學攜手佐臻,讓AI與AR智慧眼鏡走進照護第一線
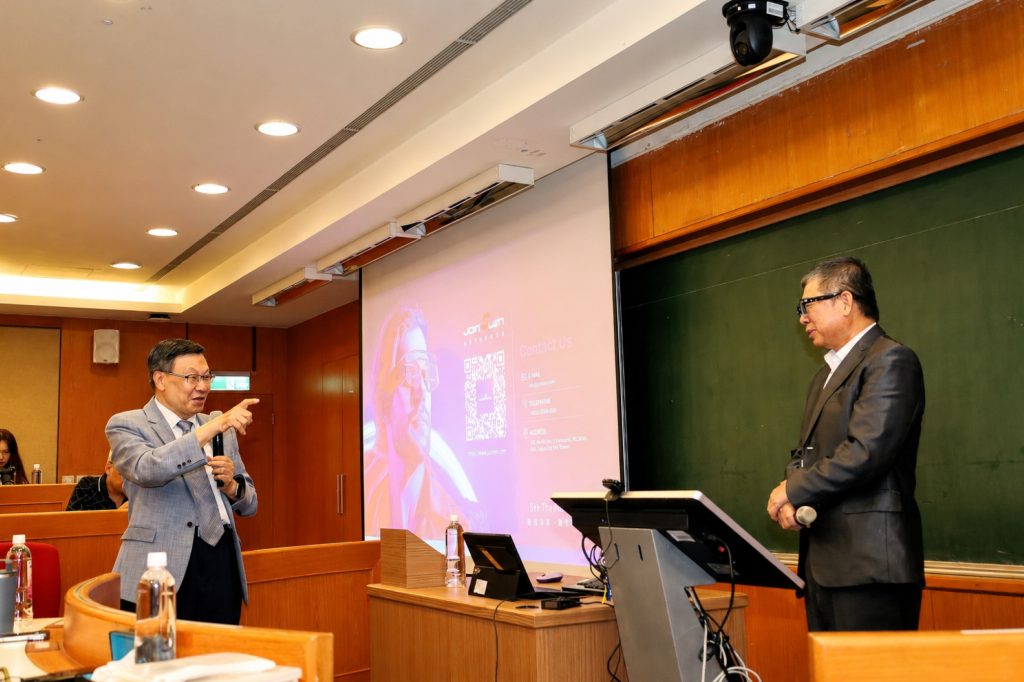
亞洲大學校長蔡進發(左)與佐臻董事長梁文隆(右),現場精彩互動。(圖 / 亞洲大學提供)
科技與醫療照護的交會,正開啟人類與資訊互動方式的新革命!亞洲大學與智慧眼鏡大廠佐臻,25日正式簽署「智慧視界・精準照護」產學合作備忘錄,宣告將智慧眼鏡推向臨床照護第一線。佐臻董事長梁文隆指出,AI與AR智慧眼鏡是「技術與應用的共生邏輯」,也是讓數位資訊與物理空間無縫融合的空間運算(Spatial Computing)與實體AI(Physical AI)重要人機互動介面,雙方將共同執行經濟部大型跨國計畫「慢性傷口 AR 智慧照護賦能系統開發與實證計畫」,結合德國 StellDirVier GmbH(SDV)與財團法人資訊工業策進會(資策會)等國際與產業資源,推動智慧眼鏡、AR輔助與護理專業導入慢性傷口照護,開創台灣臨床照護與護理教育的新里程碑。
2026-06-25 亞洲大學 發布
校長蔡進發於致詞中表示,亞大長期推動Medical AI與智慧醫療發展,近年更積極將AI融入教學與校務推動,透過課程、教師培訓與跨域計畫,培養學生具備AI素養與應用能力,蔡校長指出,智慧眼鏡結合臨床照護與護理教育,將有助於提升醫療現場效率與照護品質,期盼此次與佐臻的合作能擴大智慧眼鏡在醫院、護理教育與臨床實務中的應用。
佐臻董事長梁文隆以「智慧眼鏡新趨勢」為題進行專題演講,他表示,AI與AR智慧眼鏡並非單純的硬體產品,而是下一代人機互動與空間運算的重要介面,過去人類與AI的互動多受限於電腦與手機螢幕,未來透過近眼顯示、語音、手勢、眼球追蹤與感測技術,AI將能真正進入現實世界,形成「Physical AI」與「Spatial Computing」的應用場景。
梁文隆點出,科技演進需要computing、internet與human-computer interface三者共同推進,行動裝置改變了上一個世代的人機互動方式,而AI智慧眼鏡將有機會成為下一個世代的重要平台,佐臻長期投入AR/MR眼鏡研發,並建立硬體模組、SDK、感測技術與應用平台,期盼讓開發者、創作者、企業與醫療專業者能更容易導入智慧眼鏡應用。
佐臻董事長梁文隆(左)與亞大校長蔡進發(右)共同展示產學合作備忘錄。(圖 / 亞洲大學提供)
亞大與佐臻這次合作聚焦「慢性傷口AR智慧照護賦能系統」開發與實證,該計畫結合佐臻科技智慧眼鏡與亞洲大學護理學院的臨床照護專業,並與德國合作夥伴及相關技術團隊共同推進,預計發展包含慢性傷口3D視覺評估、AR傷口照護輔助、繪圖管理與自動化紀錄等功能,協助護理人員更有效率地完成傷口評估、照護決策與臨床紀錄。
亞大護理學院院長吳樺姍現場交流,分享智慧眼鏡融入護理教學與臨床實務的經驗。(圖 / 亞洲大學提供)
亞大護理學院院長吳樺姍表示,護理學院早已將AR智慧眼鏡導入護理技術學習場域,學生在練習臨床技能時可透過智慧眼鏡觀看正確操作流程,並在雙手釋放的情況下完成實作訓練,教師也能透過遠端視角同步掌握學生操作情形,並運用影像記錄進行學習歷程分析,吳院長提出,從早期較重的AR眼鏡,到近年逐漸輕量化與符合人性需求的智慧眼鏡產品,佐臻科技的技術發展讓護理教育與臨床照護產生更多可能。
吳樺姍也提到,本次慢性傷口智慧照護計畫整合產業技術、護理專業與國際合作資源,未來完成驗證後,將朝亞大附醫等臨床場域落地推動,並進一步申請國家級新創與大型研究計畫,擴大至急性照護、長期照護與其他臨床應用領域。
蔡進發校長總結指出,佐臻科技長期投入智慧眼鏡、AR、XR與相關產業生態系建構,並串聯台灣多項關鍵技術與產業能量,令人敬佩。亞大護理學院近年積極推動AI護理教育與智慧照護創新,已成為台灣護理教育導入AI與智慧科技的重要示範場域,並吸引多所國內外學校前來參訪交流,包括新加坡南洋理工學院、美國凱斯西儲大學(Case Western Reserve University)、澳洲西雪梨大學等國際學校,以及國內多所頂尖大學,蔡校長談及,亞大護理學院不只是展示科技,而是將AI、AR智慧眼鏡與護理教學、臨床訓練及照護流程實際結合,持續優化教學與照護品質,這次雙方簽署合作備忘錄,不只是合作成果的展現,更是未來長期合作的起點。
亞大與佐臻產學合作簽署儀式圓滿完成,貴賓合影留念。(圖 / 亞洲大學提供)
亞大與佐臻產學合作,將以智慧眼鏡為核心,結合AI、AR、感測、醫療照護與護理教育專業,推動智慧醫療科技從研發走向實證與落地應用,亞洲大學與佐臻股份有限公司期盼透過跨域合作,打造具台灣特色的智慧照護解決方案,進一步拓展至國際醫療與照護市場,展現台灣在AI醫療與智慧穿戴科技領域的創新能量。
關心更多AI智慧科技應用議題,一起來看:
鄰居變夥伴!臺科大、臺大癌醫簽署策略聯盟推動智慧醫療 首辦跨域交流會
中臺科大攜手大甲高中跨界義診助甲安埔鄉親掌握健康意識
寺院也開始學AI!玄奘大學攜手佛教會打造智慧弘法新模式
英語力決定職場競爭力!來自科技業菁英的學習心法
在全球化職場中,英語力早已成為關鍵競爭力,尤其在科技業更是基本門檻!不只高階人才需要流利溝通,即便基層工作者都有可能需要面對英文技術文件、海外會議與跨國合作。來自科技業資深經理人的第一線觀察指出:英語是進軍國際市場的敲門磚,更是職涯升遷與拓展發展性的關鍵,想在變動快速的科技業站穩腳步,從提升英語力開始,為職涯開啟更多可能!
本文導覽
職場英語的必要性科技業的快速變遷,學習是生存關鍵英語能力為職涯開啟更多可能
在全球化趨勢下,英語已成為職場上的必備技能,特別是在科技產業,無論是與國際夥伴合作、應對海外市場,甚至是與外籍同事交流,英語能力都是不可或缺的一環。
職場英語的必要性
身處科技業,李小姐深刻體會英語能力對職場發展的影響。她指出,公司業務遍及海外,無論是與外國合作夥伴討論技術細節,或是處理來自海外市場的業務往來,英語都是唯一的溝通橋樑。即使是基層工程師,日常工作仍需閱讀英文技術文件、撰寫郵件或與外籍團隊開會。「我們的人資部門經常收到來自東南亞與印度的博士班學生履歷,在各大院校舉辦招募活動時,許多外籍人才也會前來詢問職缺,這些情境都需要流暢的英語溝通能力。」李小姐說。
在科技業,寫程式與英語能力已成為基本條件,然而企業更看重的是求職者的學習心態。李小姐強調:「我們喜歡的是願意挑戰新事物、持續學習的人才,因為科技日新月異,不進步就會被淘汰。」
延伸閱讀:職場「英語力」是提升競爭力的關鍵,自主學習外更需專業助攻!
科技業的快速變遷,學習是生存關鍵
回顧自己的職涯,李小姐從一名專注於程式開發的工程師,逐步成長為負責整合系統的資深經理,參與過台北捷運售票系統的建置,也見證公司發展出人工智慧物聯網(MiAIOT)平台。她坦言:「技術推陳出新,過去的知識可能很快就會被取代,若不主動學習,十年內可能就會被市場淘汰。」
她建議在職人士保持學習動力,無論是技術精進或語言提升,都能為職場競爭力加分。透過英語學習,不僅能掌握國際趨勢,也能拓展職涯發展的可能性。透過測驗或實戰演練評估自己的英語能力,有助於找出弱點並持續精進。
英語能力為職涯開啟更多可能
在科技業,英語已不只是外語,而是打開職場機會的重要工具。無論是希望進入國際市場、與不同文化背景的同事合作,甚至是提升個人職涯發展,英語能力都扮演關鍵角色。對於想要在職場上發光發熱的專業人士來說,擁有良好的英語溝通能力,不僅能提高競爭力,也能為未來開創更多機會。
(訪談內文提供:udn聯合新聞網)
[joblist_plugin title='【全民英檢】讓求職競爭力更高!' url='https://www.104.com.tw/jobs/search/?jobsource=joblist_search&keyword=%E5%85%A8%E6%B0%91%E8%8B%B1%E6%AA%A2&mode=s&page=1&order=15&asc=0&searchJobs=1&sctp=M&scmin=50000&scstrict=1' amount='5']
強化語言能力,是提升職場競爭力的關鍵!
職場「英語力」是提升競爭力的關鍵,自主學習外更需專業助攻!
想進外商公司英文要多好?3件比考英文檢定更重要的事
AI助攻學習大躍進,開啟英語學習新時代!

有任何收穫或想分享的,都來和大家一起聊聊吧!