【線上課程】 Python 基礎程式設計|開外掛勇闖 Python 異世界
104學習

Perl
是一種歷史悠久的程式語言,擅長文字處理和系統管理自動化。因其靈活性高,常用於撰寫腳本、處理大量資料及自動化重複性工作。對於需要快速開發和維護的專案特別有用。雖然近年來新語言崛起,但在傳統系統維護、資料分析及網路管理領域仍具一定市場需求。掌握此技能有助於提升工作效率,尤其適合IT基礎設施管理和資料處理相關職務。

提升你的實力,朝專業更進一步
精選課程
充實自己,讓能力持續成長
成為 AI 科學家|快速闖關 Python 語法世界,程式實作不頭痛
Python Flask RESTful服務設計
Python進階實作-用Flask開發Line 智能客服機器人
Python程式設計【本課程為線上課,報名後專員會提供上課資訊】
Python 輕鬆上手學
隨學即用的商英 Email 寫作「模」法課!
Python 基礎程式設計|開外掛勇闖 Python 異世界
Cursor AI全端開發所:Python 網站系統獨立製作全攻略
精選證照
考取專業證照,讓能力被市場看見
SSE Python程式語言國際認證
Python語言已經是目前欲進入資訊科技殿堂最重要的程式語言,也是最好找工作的程式語言,目前大部分的人工智慧、網頁後端、機器學習、網路爬蟲、手機開發等和軟體相關的開發都是使用Python語言完成。掌握Python語言是軟體工程師最重要的技能。讓你在各個不同領域都能得心應手完成困難的工作。通過我們的認證,你將證明自己具備高人一等的Python語言開發能力。
Silicon Stone Education (SSE)
基礎程式設計 Python
基礎程式設計 Python 證照旨在驗證持有者具備使用 Python 語言進行基本程式設計的能力,涵蓋變數使用、流程控制、函式定義及簡單資料結構操作等核心技能。此證照適合初學者及希望建立程式基礎的專業人士,能有效提升求職競爭力及工作效率,廣泛應用於資料分析、自動化處理及軟體開發等領域。
尚未查核發照單位
網頁資料擷取與分析 Python
在數據分析領域及資料科學中,Python榮登最受學界、業界以及開源軟體界中最受歡迎的程式語言第一名。Python強項在於語句少而簡潔,高開發效率與高生產力,幫助開發者可以專注在解決問題上,用途廣泛,使用者來自各個領域。在物聯網興起的時代,大數據資料需要經由數據分析,進而找出資料能提供的資訊。Python具有豐富強大的程式庫,能高彈性運用Python的各項套件模組,進行數據資料演算,以幫助企業降低成本、挖掘出資料庫中的各類商機,做為後續的智慧應用資料依據。
財團法人中華民國電腦技能基金會
程式語言 (C/Python)
TQC+ 程式語言C認證之測驗對象,為從事軟體設計相關工作1至2年之社會人士,或是受過軟體設計領域之專業訓練,欲進入該領域就職之人員。
TQC+ 程式語言Python 3認證之測驗對象,為從事軟體設計相關工作1至2年之社會人士,或是受過軟體設計領域之專業訓練,欲進入該領域就職之人員。
學科技能規範:無技能規範
術科技能規範:
1. 基本程式設計
2. 選擇敘述
3. 迴圈敘述
4. 進階控制流程
5. 函式(Function)
6. 串列(List)的運作(一維、二維以及多維)
7. 數組(Tuple)、集合(Set)以及詞典(Dictionary)
8. 字串(String)的運作
9. 檔案與異常處理
財團法人中華民國電腦技能基金會
Python程式設計應用認證
本證照關於Python程式設計必學基礎概念,例如變數、串列、類別和迴圈等主題,並對每個主題實作練習寫出淺顯易懂的程式碼。
學到如何讓程式產生互動性,以及如何在程式整合到專案前正確也測試好編寫的程式碼。
TIPCI臺灣國際專業認證學會
SSE C程式語言國際認證
C語言已經是目前欲進入資訊科技殿堂最重要的程式語言,也是最好找工作的程式語言,目前大部分的半導體,工業工程,無人車,虛擬實境和手機開發等和硬體相關的開發都是使用C語言完成。掌握C語言是軟體工程師最重要的技能。讓你在各個不同領域都能得心應手完成困難的工作。通過我們的認證,你將證明自己具備高人一等的C語言開發能力。
Silicon Stone Education (SSE)
精選貼文,掌握第一手知識
「Skill」和「提示詞」差在哪?6大差異與SKILL.md寫法一次看
Skill和提示詞差在哪?會寫提示詞還需要學Skill嗎?作者認為,提示詞就像便利貼,而Skill則像一本SOP手冊,以下從可複用性、穩定性、分享、跨平台、版控與自動化等6大面向比較,並以實例解析SKILL.md的5大結構與寫法。本文節錄自《10 倍速!AI Skill 全攻略》。
文/曾慶良(阿亮老師)
本文目錄(點擊可快速前往)
「提示詞」和「Skill」的6維度差異維度一:一次性 vs 可複用維度二:不穩定 vs 穩定維度三:無法傳承 vs 可分享維度四:單平台 vs 跨平台維度五:無版控 vs 有版控維度六:手動觸發 vs 自動觸發Skill怎麼寫?5個區塊快速解構SKILL.md1. 名稱2. Description(描述)3. Steps(步驟)4. Rules(規則)5. Example(範例)
「我用ChatGPT的提示詞不是也很好用嗎?為什麼還要學Skill?」
這是我在課堂上最常被問到的問題。每次我都會用一個比喻來回答。
提示詞就像便利貼。你在上面寫了一段很棒的指令,貼在螢幕旁邊。每次要用的時候,你看一眼便利貼,然後在AI的對話框裡重新打一遍。打完用完,那段文字就留在對話裡了—你關掉視窗,它就消失了。下次要用?再打一遍。換一台電腦?找不到了。想分享給同事?「你等一下,我翻一下之前的對話紀錄⋯⋯」
Skill則像一本裝訂好的SOP手冊。它不會丟、不會改、不會因為你換了電腦就消失。你把它放在一個固定的地方,AI每次都會翻開同一本手冊、照同一套流程做事,品質永遠一致。要分享?直接丟一個檔案過去,3秒鐘搞定。但差別不只是「便利貼 vs 手冊」這麼簡單。讓我從6個維度來做完整的比較,每個維度都配一個具體場景,讓你一次看透兩者的差異。
「提示詞」和「Skill」的6維度差異
維度一:一次性 vs 可複用
提示詞是一次性的。你在ChatGPT裡打了一段很精緻的提示詞,產出了一份完美的報告。太好了!但3天後你又需要寫一份類似的報告,你回頭翻對話紀錄—那段提示詞埋在100條對話之中,你翻了5分鐘才找到,然後發現它跟另一段提示詞混在一起,你搞不清楚到底哪段是你要的。
Skill是可複用的。你把「產出行銷月報」的流程寫成一個Skill。每個月月初,你只要說「幫我做這個月的行銷月報」,然後丟入數據,AI就照同一套格式、同一套邏輯跑出報告。第一個月花30分鐘寫Skill,之後每個月省2小時。用12個月,你省了23個半小時—整整3個工作天。
維度二:不穩定 vs 穩定
提示詞的輸出品質靠你的措辭。你今天心情好,打了一段很完整的提示詞,AI給你90分的答案。明天你趕時間,少寫了兩個條件,AI給你60分的答案。同一個任務,品質可以差出30分。更麻煩的是,你往往不知道品質下降是因為你的提示詞不一樣了—你以為自己打的「差不多」,但AI對措辭的敏感度超乎你的想像。
Skill的輸出品質被規則鎖住。SKILL.md裡的Rules區塊寫了「MUST:每段開頭要有bullet point摘要」和「NEVER:不可以使用超過3層的巢狀標題」,AI就會每次都遵守。你不需要記住這些規則,因為它們已經被寫進了系統裡。品質一致性從「看心情」變成「看規則」。
維度三:無法傳承 vs 可分享
提示詞是個人知識,藏在你的腦袋裡。你花了3個月才摸出一套高效率的AI工作方式。主管說:「太好了,教教其他人吧。」你開始教,講了1個小時。同事點頭如搗蒜,回去自己試—結果做出來的東西跟你的完全不一樣。因為你教的是「大方向」,真正決定品質的那些「眉角」(語氣怎麼拿捏、哪些詞要避開、先做A再做B的順序不能反),都是你自己也說不清楚的隱性知識。
Skill是一個檔案,誰拿到都能用。你把SKILL.md丟給同事,他花5分鐘讀完,對AI說「跑這個Skill」,出來的結果跟你做的品質一模一樣。隱性知識被「外化」成顯性知識,經驗不再只存在某個人的腦子裡。一個新人入職第一天就可以用資深員工花3個月磨出來的AI工作流—這在以前是不可能的事。
維度四:單平台 vs 跨平台
提示詞綁定在特定的AI平台上。你在ChatGPT裡養了一個好用的Custom GPT,有一天公司決定改用Claude,你的心血全部白費—Custom GPT的設定沒辦法直接搬到Claude上面。或者你在Gemini裡摸出一套好用的提示詞,但發現在ChatGPT上跑出來的結果完全不一樣,因為每個平台對提示詞的「理解方式」有微妙的差異。
Skill是一份純文字檔,不綁定任何平台。同一份SKILL.md,你可以在Claude Code裡用、在Gemini CLI裡用、在Codex CLI裡用。因為Skill的本質是自然語言寫的工作流程,任何能讀懂自然語言的AI都能執行。你今天用Claude,明天改用GPT,後天改用Gemini—Skill帶著走,不用重寫。
維度五:無版控 vs 有版控
提示詞沒有版本的概念。你改了一段提示詞,發現效果變差了,想回到上一版—抱歉,你已經覆蓋掉了。或者你跟同事各自改了同一段提示詞的不同部分,想合併—你得自己手動比對,一行一行看。
Skill是檔案,可以用Git做版本控制。每一次修改都有紀錄,你可以看到「上個禮拜三下午兩點誰改了什麼」。改壞了?一個指令回滾。多人協作?用Git的分支和合併機制,兩個人改同一份Skill也不怕衝突。這就是軟體工程師幾十年來管理程式碼的方式,現在你用同樣的方式管理AI的行為。
維度六:手動觸發 vs 自動觸發
提示詞需要你手動執行。你得打開AI介面、貼上提示詞、貼上輸入資料、按下送出、等待回覆、複製輸出、貼到目標位置。每一步都要你親自動手。如果你的工作流有10個步驟,你就要重複這套「開→貼→送→等→複製→貼」的動作10次。
Skill可以被自動觸發。在後面的章節你會學到Skill Chain(Skill串接),讓A Skill的輸出自動變成B Skill的輸入,中間完全不需要你動手。你甚至可以設定排程—每天早上9點自動跑「整理今日待辦事項」Skill,或者每次收到特定格式的Email就自動觸發「客戶回覆」Skill。從「人工一步一步做」變成「設定一次自動跑」。
如果用一句話總結整個對比:提示詞是即用即丟的紙條,Skill是裝訂成冊的工作手冊。
這6個維度的差距,不是功能多寡的差距,而是「工作方式」的差距—一種是每次從零開始,一種是把好的做法固定下來、持續複利。
Skill怎麼寫?5個區塊快速解構SKILL.md
你可能會好奇:一個SKILL.md到底長什麼樣子?裡面有哪些東西?
其實它的結構非常簡單。一個標準的SKILL.md有5大區塊:名稱(Name)、Description(描述)、Steps(步驟)、Rules(規則)、Example(範例)。每一塊的作用不同,但都是用自然語言寫的—你會打字就會寫,不需要任何程式背景。
讓我用一個完整的例子帶你走一遍。假設你是一個社群小編,每天要寫Facebook貼文。你想讓AI幫你寫,但又要確保風格一致、長度合適、不要踩到地雷。這就是一個非常適合做成Skill的任務。
先看完整的樣子:
# 社群貼文產生器## Description當使用者提供主題和素材,自動產出一篇適合Facebook粉絲頁的貼文。## Steps 1. 確認貼文主題和目標受眾2. 從素材中提取三個重點3. 用「故事→觀點→行動呼籲」的三段式結構撰寫4. 加入 3-5 個相關 Hashtag 5. 檢查字數是否在 150-300 字之間## Rules- MUST:開頭第一句話要有「鉤子」,引起好奇心- MUST:結尾要有明確的行動呼籲(留言、分享、點連結)- MUST:語氣親切自然,像朋友聊天- NEVER:不使用「最」「第一」「保證」等絕對性用語- NEVER:不提及競品名稱## Example** 輸入:** 主題是「新推出的線上課程」,受眾是 25-35 歲上班族** 輸出:**你有沒有過這種經驗?下班回家想學點新東西,打開線上課程卻不知道從何開始⋯⋯我們聽到了!全新的「AI工作術」系列課程,專門為忙碌的上班族設計。每堂課只要15分鐘,通勤的時候就能看完。3個月後,你會發現自己處理工作的速度快了一倍。想搶先體驗嗎?留言「+1」我們私訊你早鳥優惠連結 👇 #AI工作術 #線上學習 #下班後充電 #職場成長
編按:撰寫Skill不一定要從空白的SKILL.md開始,也可以藉由AI工具輔助,例如Claude的「skill-creator」可根據自然語言需求,協助產生Skill的檔案結構與內容,並進一步測試、比較及優化;OpenAI Codex也內建「$skill-creator」。需要注意的是,產生的Skill仍應由使用者親自檢查,因此了解下文拆解的SKILL.md相當重要。
現在讓我一塊一塊解說。
1. 名稱
讓AI知道「這是哪個Skill」。
2. Description(描述)
這是Skill的「自我介紹」。用一到兩句話說清楚:這個Skill在什麼情境下會被觸發,它會做什麼事。AI會根據這段描述來判斷「使用者現在的需求適不適合用這個Skill」。
寫得好的Description有3個特徵:第一,明確說出觸發條件(「當使用者提供主題和素材」);第二,明確說出輸出結果(「產出一篇Facebook貼文」);第三,不超過兩句話。你不需要在這裡塞太多細節—細節是 Steps 和 Rules 的事。
一個好Description的迷你範例:
當使用者貼上一段英文文獻摘要,自動翻譯成學術中文並標註關鍵術語。
一個不好的Description的反面教材:
這是一個很厲害的翻譯工具可以翻譯很多東西而且翻得很好。
差在哪?好的版本告訴AI「什麼時候用、輸入什麼、輸出什麼」;不好的版本只在自吹自擂,AI讀完還是不知道自己該做什麼。
3. Steps(步驟)
這是Skill的「工作流程」。用編號列表寫出AI應該依序完成的每一個步驟。AI會從第一步做到最後一步,不跳步、不亂序。
寫Steps的關鍵是「粒度」—每一步不能太粗(「寫一篇貼文」,那跟沒寫一樣),也不能太細(「先按下鍵盤上的A鍵」,那是在教幼兒園小朋友)。一個好的經驗法則是:每一步對應一個「可以獨立驗收的產出」。比如「從素材中提取3個重點」,做完這一步你可以看到3個重點,可以判斷對不對。
一個做會議紀錄的Steps迷你範例:
1. 讀取會議逐字稿2. 辨識所有參與者及其發言3. 歸納3到5個主要討論議題4. 為每個議題摘要結論和待辦事項5. 用表格格式整理成會議紀錄
4. Rules(規則)
這是Skill的「紅線」。用MUST(一定要)和NEVER(絕對不可以)來框住AI的行為。這是整個SKILL.md裡最重要的區塊—沒有之一。
為什麼?因為 AI 最大的問題不是「不會做」,而是「做過頭」或「做歪了」。它太聰明了,聰明到會自己加料。你請它寫一封客服回覆,它可能自作主張承諾退款;你請它寫一篇新聞稿,它可能自己加了虛構的數據。Rules就是用來「馴服」AI的—你畫出邊界,它在邊界裡自由發揮。
MUST和NEVER的寫法有一個要訣:越具體越好。「MUST:寫得好」是廢話;「MUST:每段不超過80字」是有用的規則。「NEVER:不要亂寫」是廢話;「NEVER:不引用未經確認的統計數據」是有用的規則。
一個寫學術摘要的Rules迷你範例:
- MUST:使用被動語態和第三人稱- MUST:保留所有數據和百分比- MUST:字數控制在 250 字以內- NEVER:不加入原文沒有的推論- NEVER:不使用口語化表達
5. Example(範例)
這是Skill的「示範教學」。你給AI看一組「輸入→輸出」的配對,讓它知道「做對了長什麼樣子」。這就像你訓練新員工:與其說一百條規則,不如直接拿一份做好的成品給他看—「就照這個標準來。」
Example不需要多,一到兩組就夠了。但要挑有代表性的例子。如果你的Skill會處理3種不同類型的輸入,最好每種類型各給一個範例。
一個寫產品文案的Example迷你範例:
** 輸入:** 產品名稱:極光藍芽耳機,特點:降噪、12小時續航、IPX5 防水** 輸出:** 城市再吵,你的世界可以很安靜。極光藍芽耳機搭載主動降噪技術,12小時超長續航陪你從早到晚,IPX5防水等級讓你運動時也能盡情享受音樂。
5大區塊就是這樣。名稱讓AI知道「這是哪個Skill」, Description告訴AI「什麼時候該啟動」,Steps告訴它「怎麼做」,Rules告訴它「什麼可以做、什麼不可以做 」, Example告訴它「做對了長什麼樣子」。5塊加在一起,你就完整地「教會」了AI一項技能。
記住:你不需要一次寫到完美。先寫一版,跑跑看,發現AI哪裡做不好就回去調整Rules或Steps。Skill是活的文件,會隨著你的使用而越來越精準。
節錄自:博碩《10 倍速!AI Skill 全攻略:建立 Skill 驅動 AI 系統,打造從學術研究到專案開發的自動化工作流》/曾慶良(阿亮老師) 著
推薦閱讀:
Claude Skills怎麼用?內建與個人Skill差異、適用情境及使用方式
Claude怎麼用?免費版有什麼限制?Chat、Cowork、Code及實用功能盤點
精選 AI寫企劃、看數據總是不能用?4種工作先排順序再交代,第一版就能討論
請AI寫企劃、做研究、看報表,結果常常看起來很完整,卻不能直接用?
問題多半不在AI的能力,而在我們只說「幫我寫」「幫我分析」,讓它自己猜目的和標準。
四種常見工作,可以共用同一個骨架:
1. 交代目的與標準:給誰看?看完要做什麼決定?
2. 排好先後步驟:先要中間產物,確認後再往下做
3. 要求附上依據:出處、算法、引用原文,讓你能驗收
套到四種工作,各有一個先後順序:
① 寫企劃|架構先定,內容後補
先寫明讀者與目的,請AI只給三個主張和大綱;確認後才補內容,每個數據都附出處,查不到就標「待查證」。
② 做研究|大題切小題,說法衝突並陳
先把大問題切成四到五個能用資料回答的小題;每題比對三種來源、標出年份;說法互相衝突時,請AI並列出來,由你判斷。
③ 看數據|問題先行,數字在後
不要只丟報表說「幫我分析」,先寫成決策問題,例如「上季回購率下滑,是哪一群顧客流失」;講好期間、欄位和比較基準,只要兩三個關鍵發現,並附計算方式。
④ 審提案|先找漏洞,後打分數
先逐條列漏洞並引用提案原文、分出輕重;再依事先講好的配分計分;最後請AI扮反方,提出最強的反對意見。
最常見的三個錯誤:
・一開口就要整篇成品,方向錯了只能整篇重寫
・AI給的數字沒查就直接用
・一邊挑毛病一邊打分數,分數被第一印象帶走
小練習:挑一件你這週要交的工作,寫下這兩句再交給AI——
「這份東西給__看,看完要他__。」
「先給我__(大綱/小題清單/漏洞清單),我確認後再繼續。」
比較一下,和你平常的第一版差在哪裡。
想看完整的五分鐘影音說明,104學習免費課程「AI工作術」四堂已經上線,免費報名就能看:
第1堂|5分鐘學會用AI寫企劃
https://nabi.104.com.tw/course/104nabi/57aed01b-9d82-4438-b09e-e2367abc0207
第2堂|5分鐘學會用AI做研究
https://nabi.104.com.tw/course/104nabi/595a665d-07a3-461d-b37e-1f8158eca70d
第3堂|5分鐘學會用AI看數據
https://nabi.104.com.tw/course/104nabi/0f3d424e-1658-49a2-851e-6c9fff296f43
第4堂|5分鐘學會用AI審提案
https://nabi.104.com.tw/course/104nabi/19983d11-9e93-41ae-9924-46f8d6cd47dd
也歡迎在留言分享:這四種工作,你最常請AI幫忙哪一種?有沒有哪一次的第一版特別好用(或特別難用)?
使用提醒:AI可能出錯,重要數字請自行查證;上傳資料前先確認公司規定,並去除姓名、電話等個資。文中案例皆為假設情境。
「常用」的英文怎麼說?帶你認識五個英文單字!
「常用」的英文到底該用哪個字?本篇文章將帶你認識 common、frequently used、popular、widely used 和 essential 這五個單字,並分析它們的使用場合和差異,讓你在寫作和對話中都能選擇最適合的詞彙,提升語言表達的精準度!
1. Common
• 解釋:指經常見到或普遍使用的
• 例句:Email is a common tool for workplace communication.
電子郵件是職場中常用的溝通工具。
• 例句:It’s common to use “Ctrl + C” for copying text on a computer.
在電腦上使用「Ctrl + C」來複製文字是常見的做法。
• 例句:Email is a common tool for workplace communication.
電子郵件是職場中常用的溝通工具。
2. Frequently Used
• 解釋:表示經常被使用的,更強調頻率
• 例句:This app’s frequently used features include reminders and notes.
這款應用程式的常用功能包括提醒和筆記。
• 例句:The company provides a list of frequently used phrases for customer service.
公司提供了一份客服常用語句列表。
• 例句:This app’s frequently used features include reminders and notes.
這款應用程式的常用功能包括提醒和筆記。
3. Popular
• 解釋:表示受歡迎或流行的,通常用於描述廣泛使用的事物
• 例句:This is one of the most popular software tools among designers.
這是設計師中最常用的軟體工具之一。
• 例句:Zoom became popular for virtual meetings during the pandemic.
疫情期間,Zoom 成為常用的線上會議工具。
• 例句:Zoom became popular for virtual meetings during the pandemic.
疫情期間,Zoom 成為常用的線上會議工具。
4. Widely Used
• 解釋:指被廣泛使用的,多用於正式語境
• 例句:English is a widely used language in international business.
英語是國際商務中常用的語言。
• 例句:This system is widely used in large-scale manufacturing.
這套系統在大型製造業中被廣泛使用。
• 例句:English is a widely used language in international business.
英語是國際商務中常用的語言。
5. Essential
• 解釋:指必需的或經常用到的重要事物,有時可以引申為「常用」
• 例句:A good dictionary is an essential tool for learning a new language.
一本好的字典是學習新語言時的常用工具。
• 例句:This guide provides essential information for first-time users.
本指南提供了初次使用者的常用資訊。
• 例句:A good dictionary is an essential tool for learning a new language.
一本好的字典是學習新語言時的常用工具。
▍使用場景簡單比較
• Common:一般情況
• Frequently Used:強調頻率
• Popular:最常用的,偏向形容流行性或受歡迎程度
• Widely Used:強調廣泛使用的普遍性
• Essential:表示「不可或缺」,通常用來形容重要事物
五個「常用」的英文單字,這是本次分享!記得加入我們的共學教室!
工作很熟卻一講英文就卡住?用「PREP」提升職場英文溝通力
明明很熟悉工作內容,卻一開口講職場英文就卡住?問題通常不是單字不夠,也可能是資訊還沒排好順序。本文教你用PREP 4句話把交期延遲、技術報告與數據結論等情境說清楚,附中英對照範例。
文/104學習
本文目錄(點擊可快速前往)
PREP:先讓對方掌握主線【情境1】交期延遲:先說新的日期【情境2】技術報告:把細節連到決策【情境3】數據說明:結論要有邊界3個小調整,讓專業更容易被理解用「PREP」把專業說清楚:從筆記開始完成4句話
明明很熟悉工作內容,一開口講英文,卻不知道從哪裡開始?
向客戶解釋交期延遲,背景說了半天,對方還在問新的交貨日期。向主管報告技術問題,排查過程講得很完整,卻沒有清楚提出建議。問題不一定是英文能力不足,也可能是資訊還沒排好順序。
搭配本課程的5分鐘影片,你可以先閱讀,再聆聽中英文示範,最後跟著練習自己的4句話。
來源/104學習製作
PREP:先讓對方掌握主線
PREP是結論(Point)、原因(Reason)、例子(Example)、重申結論(Point)的表達順序。最後一步也可以進一步提出行動。
結論:The key point is that… 最想讓對方知道什麼?
原因:This is because… 為什麼會這樣?
例子:For example,… 哪個事實能支持說法?
下一步:That’s why we recommend… 接下來建議怎麼做?
結論可以是目前狀況、你的判斷或建議;例子可以是一筆數據、一次測試結果或一個具體事件。
【情境1】交期延遲:先說新的日期
「零件晚到了,我們聯絡供應商,安排組裝,也討論了運輸……」這些資訊可能都是真的,但客戶仍不知道何時能交貨。
試著改成這4句:
P:We need to move the delivery date from June 10 to June 13.我們需要將交貨日期從 6 月 10 日調整至 6 月 13 日。
R:This is because a key component arrived later than scheduled.原因是一項關鍵零件比原定時間晚到。
E:For example, the control modules arrived on Tuesday instead of Friday, so final assembly started two working days late.例如,控制模組原定週五到貨,實際週二才收到,因此最終組裝晚了兩個工作天才開始。
P:The revised delivery date is June 13. We’ll send you a progress update tomorrow.調整後的交貨日期是6月13日。我們明天會向您更新進度。
必要時可以簡短致歉,同時清楚交代日期、原因與後續安排。
【情境2】技術報告:把細節連到決策
你可能花了3天找問題,但主管需要先知道的是:發現什麼風險,以及你建議怎麼做。
I recommend postponing the software release until we fix the connection issue.我建議延後軟體發布,等連線問題修復後再上線。
再說明系統在高負載時可能斷線,並以測試結果支持判斷:500人同時連線,發生3次連線中斷。最後提出修復與重新測試的行動:
That’s why I recommend fixing the issue and repeating the load test before release.因此,我建議先修復問題並重新進行負載測試,再發布軟體。
這樣的報告讓對方能夠理解風險,也有具體建議可以討論。
【情境3】數據說明:結論要有邊界
影片中的假設情境是:30個樣品的最高量測值為每公升8.2毫克,低於每公升10毫克的指定限值。
你可以說:
The tested samples met the acceptance criterion under the specified test conditions.受測樣品在指定試驗條件下符合允收標準。
「受測樣品」「此項標準」「試驗條件」都不可省略。有限的結果不能擴大為對產品整體的保證,口頭說明也不能取代完整試驗資料與必要文件。
3個小調整,讓專業更容易被理解
一次只說一個核心結論。先問自己,希望對方聽完記住哪件事,再選擇相關資訊。
用具體事實取代模糊形容詞。不要只說系統很慢,可以說「回應時間從2秒增加到8秒」。數字不必多,但要能支持結論。
最後一句帶出行動。例如:Could you approve the revised timeline? 您可以核准調整後的時程嗎?
用「PREP」把專業說清楚:從筆記開始完成4句話
假設還有3個樣品要重測,需要多兩天,就可以整理成:
We need two more days to complete the test.
This is because we need to verify the results.
For example, three samples require another test.
Could you approve the revised timeline?
每一句都有任務:提出結論、解釋原因、提供依據、帶出下一步。
看完影片後,找一件真實工作事項。用5分鐘依序寫下結論、原因、例子和下一步,最後用英文念一遍。句子太長就拆短,刪掉不影響理解的背景。
你不需要先學會更多艱深單字,就能開始把熟悉的專業說得更清楚。
全民英檢中級閱讀常選錯?用上下文與原文證據破解詞彙、段落填空與閱讀理解
全民英檢中級閱讀的單字大多認得,為什麼還是會選錯?因為答案常取決於前後句的關係,以及選項有沒有改變原文的範圍。這篇用三題原創例題,示範怎麼找證據、逐一核對選項。
本文目錄
全民英檢中級閱讀考什麼?
核心方法:先判斷關係,再定位、核對範圍
原創例題示範:詞彙、段落填空與公告閱讀
錯題回查:把錯誤分清楚類型
常見錯誤與修正
動手做2個閱讀練習
資料來源與教學說明
這個方法不要求每個字都先翻成中文,但要求你能說出選答案的依據。解析時,比較的是證據,不只是答案字母。
搭配本課程5分鐘影片,先看重點,再用下面的整理與練習確認理解。
影片/全民英檢中級入門系列第3堂:中級閱讀,用上下文核對答案
全民英檢中級閱讀考什麼?
題型題數本文示範詞彙10題詞彙短例段落填空10題(兩個段落,每段5個空格)單一空格示範閱讀理解15題(5個題組)圖書館公告
閱讀共35題,作答45分鐘。本文的填空示範只留一個空格,是為了看清判斷步驟,不代表完整正式題組的長度。
核心方法:先判斷關係,再定位、核對範圍
填空題先讀前後句:判斷是原因帶出結果、兩件事互相對比,還是再補一個例子,再檢查選項的語意與句型能不能接上。
閱讀理解先看問題要找什麼:回到原文定位,找到相關句子後,向前後多讀一句,確認人物、時間與適用範圍。
核對選項:文章有沒有提到?選項說的是不是同一個對象與時段?語意有沒有被擴大或顛倒?
選項可能用同義說法改寫,不能只找完全相同的單字;反過來說,選項即使抄了原文的字,也可能把部分改成全部、把開放說成關閉,或加進原文沒提到的理由。
圖解|上下文與選項核對的三個步驟
原創例題示範:詞彙、段落填空與公告閱讀
例題1|詞彙
The museum is popular, so visitors should _____ tickets online in advance.A. book B. borrow C. rent D. lend
答案:A。popular、online 與 in advance 三個線索,指向事先預訂門票。borrow 是向別人借入、lend 是借給別人,方向相反;rent 是付費租用。不能只照中文的「借」或「租」來選,要回到題目看訪客要做什麼。
例題2|段落填空
Mia usually cycles to work. Yesterday, it rained heavily. _____, she took the bus instead.A. However B. Therefore C. For example D. Meanwhile
答案:B。大雨解釋了為什麼改搭公車,空格需要表示結果。別只看到「騎車」與「搭公車」不同就選 However,中間的大雨也要讀進來。
例題3|閱讀理解
Library notice: The second-floor reading room will be closed for painting from Monday to Wednesday. The first-floor reading area will remain open. Please return borrowed books at the front desk, as the outdoor return box will also be closed during this period.Which statement is correct?A. The whole library will be closed on Monday.B. The outdoor return box can be used on Tuesday.C. Books can be returned at the front desk on Tuesday.D. The first-floor reading area is being painted.
選項判斷錯誤類型A只有二樓閱覽室關閉,一樓仍開放範圍擴大B戶外還書箱在公告期間也關閉資訊顛倒C星期二在公告期間,應到服務台還書正確答案D公告只說二樓因油漆關閉原文未提
錯題回查:把錯誤分清楚類型
若選了「整館關閉」,除了二樓關閉,也要讀到「一樓仍開放」那句,才知道漏了限制範圍的證據。
若把關閉時間看成整週,要核對公告只寫星期一到星期三。
認得 closed,卻把一樓和二樓混在一起,記成「對象看錯」,練習對照區域。
連 closed 的意思都不確定,記成「字彙不懂」,先補這個字的理解與辨認。
最後把原文證據縮成一句話,不必抄整篇文章,只要保留對象、時間與狀態,就能快速回查。
圖解|把方法放進三種題型
常見錯誤與修正
只看空格旁邊的一個字。
把原文的局部資訊放大成全部。
用自己的常識替文章補充內容。
選項有兩個主張時,只核對前半句。
兩個選項都像對的時候,分別找出支持它們的原句,再比較有沒有多加限制或改掉對象。不要用「選項比較長」「單字比較難」當作正確的理由。
動手做2個閱讀練習
練習1:重讀圖書館公告,在四個選項旁分別寫下支持或排除的原文證據。
解析:A 範圍擴大、B 資訊顛倒、C 有原文支持、D 原文未提。能說出每個選項錯在哪個字或哪個範圍,才算完成。
練習2:用中文一句話,區分公告中的關閉區域與照常開放區域。
解析:星期一到星期三,二樓閱覽室與戶外還書箱關閉;一樓閱讀區照常開放,還書請到服務台。
資料來源與教學說明
本文的成績案例、例句、短文、對話與看圖情境皆為原創教學示範,不是官方題庫;寫作與口說提供的是參考答案,未經官方評分,也不保證特定級分。「原安排/變動/最後結果」「先答重點、再補理由」等是教學整理,不是完整的官方評分規則。報名日期、場次、成績效期與個人報考資格,請以LTTC全民英檢官網最新公告為準。
資訊查核日期:2026-10-16。
LTTC全民英檢:中級測驗說明(測驗內容、題型、通過標準)
LTTC全民英檢:中級練習題(寫作中文提示、看圖敘述題目呈現)
全民英檢中級入門系列|接著讀下一堂
第1堂|全民英檢中級怎樣算通過?聽讀160分與單項72分門檻
第2堂|中級聽力怎麼抓答案?追蹤原安排、變動與最後決定
第4堂|中級寫作怎麼準備?翻譯先達意、作文先切題
第5堂|中級口說怎麼答?回答有延伸、看圖有順序
全民英檢該考哪一級?初級到優級差異、使用時機與報名流程
[joblist_plugin title='更多104【全民英檢】工作機會' url='https://www.104.com.tw/jobs/search/?keyword=%E5%85%A8%E6%B0%91%E8%8B%B1%E6%AA%A2' amount='3']
川普說話為何又短又直接?從菁英語言到「政治不正確」,拆解川普式無敵語法
川普現在的說話方式,給人的印象往往是短句、重複、直接,甚至刻意挑戰政治正確。法國犯罪學名譽教授包(Alain Bauer)認為,這可能只是一層煙幕:1980年代的川普,說的是句構複雜、詞彙精細的紐約菁英語言風格;在他看來,川普並非喪失這種表達能力,而是選擇「假裝失去」。這套刻意簡化的語法從哪裡學來,又是如何運作?本文節錄自《川普式無敵語法》。
文/包(Alain Bauer)
本文目錄(點擊可快速前往)
政治語言退化?其實是他刻意顛覆不只要擊敗、還要羞辱對手「無敵語法」導師教他的第一條鐵律:永不道歉
對許多評論者而言—而且不僅限於歐洲—人們傾向將「唐納.川普」這個人物,加以「精神病理化」解讀,彷彿他更像是一名病人,而非一位政治家。
於是,他那種介於自我膨脹與傲慢之間的表現,被用來解釋其言論的粗暴、混亂與挑釁。
但如果事實並非如此呢?
如果這一切,只是一層煙幕,用來遮蔽更關鍵的本質,即使這個人確實存在種種誇張與失控的表現?
事實上,川普的崛起,並非美國政治史上的偶發事件。它更像是一場政治革命的結果,而這場革命的核心,是一種「語言上的起義」:透過精心設計、系統化運用「政治不正確」的語彙,重塑公共論述。
這種語言策略的根源,在於他對大眾說服機制有著極為敏銳的理解。
與那些將此現象視為「政治語言自然退化」的表層分析不同,川普的溝通風格其實展現出高度精密的策略設計,是為了瓦解既有制度規範的正當性,並將其轉化為自身優勢。
政治語言退化?其實是他刻意顛覆
這樣的轉變既非偶然,也不是認知能力的衰退,而是經過計算的「表演」,源頭可追溯至其導師—律師羅伊.科恩(Roy Cohn)的教導,並在注意力經濟的環境中被進一步強化與調整。川普比同時代多數人更早理解:在21世紀初的美國,若要透過民主機制取得權力,就必須發明一種新的語言――一種經過組織的「語言顛覆策略」。
這位在1980年代與1990年代,能以紐約菁英階級慣有的精細概念與複雜句法發言的人,其實並未喪失思考能力。他選擇「假裝失去」,以便贏得那些對傳統統治階層語言無感、甚至反感的選民。這種模擬,很可能是現代政治史上最大膽的修辭操作之一,一方面塑造出貼近民間的真誠形象,另一方面運用了極其高階的說服技術。
回顧1980年代至1990年代的電視資料,可以看到一個與2015年至2028年間(首次參選至任期最後一年)截然不同的川普。他當時接受美國主流媒體訪問,所展現出的豐富概念詞彙,以及能靈活運用語意的細節,顯示出他對菁英語言規則的熟稔掌握。
川普這一時期的語言風格,具備高度成熟的特徵:句構複雜、從句(Clause,譯按:又稱從屬子句〔Subordinate Clause〕,意指複合句中無法獨立成句、依附於主句之下的子句)運用精巧、隱含文化參照,論述結構也符合傳統修辭學的規範。
作為一名企業家,他的發言方式完全符合其身分—一位受過國際談判訓練、熟悉金融權力運作的美國經濟菁英。
針對其當時媒體發言的語言學研究也顯示,他經常使用正式語域(Register,譯按:可以按照用途區分的語言變體,也就是指根據話題、說話對象、對話媒介、所在場合等,使用不同的語言風格或語言層次),詞彙多樣且句法結構精細。這種表達上的豐富性,與他日後在政治舞臺上刻意採取的簡化語言,形成強烈對比。
例如,在1990年3月刊於《花花公子》(Playboy)的專訪中,他談到國際貿易時表示:
人需要自尊,整個國家也需要自尊。我認為我們的國家需要更多自尊,因為我們正被所謂的盟友剝削,例如日本、西德、沙烏地阿拉伯、南韓等。它們的自尊徹底超越了這個國家,因為它們掌控著史上最龐大的金錢機器,而這一切是建立在我們的負擔之上。它們的產品更好,是因為獲得了大量補貼。我們美國人之所以被全世界嘲笑,是因為我們年復一年損失1,500億美元,去保護那些富裕國家—如果沒有我們,它們15分鐘內就會從地球上消失。
(People need ego, whole nations need ego. I think our country needs more ego, because it is being ripped off so badly by our so-called allies; i.e., Japan, West Germany, Saudi Arabia, South Korea, etc. They have literally outegotized this country, because they rule the greatest money machine ever assembled and it’s sitting on our backs. Their products are better because they have so much subsidy. We Americans are laughed at around the world for losing a hundred and fifty billion dollars year after year, for defending wealthy nations for nothing, nations that would be wiped off the face of the earth in about fifteen minutes if it weren’t for us.)
同樣的,他在1987年9月於《紐約時報》(The New York Times)等媒體刊登的整版公開信,也展現出類似的論述風格。
35年後,到了2025年,他的核心觀點幾乎沒有改變,表達形式卻被大幅簡化。在各種記者會上,他的說法變成:「他們在剝削我們。納稅人被剝削超過50年了。但這種情況不會再發生。」(They’re ripping us off. Taxpayers have been ripped off for more than fifty years. But it is not going to happen anymore.)
不只要擊敗、還要羞辱對手
川普在2000年一度要代表美國改革黨(Reform Party of the USA)參選的經歷,提供了一項關鍵證據,說明他日後語言簡化的「表演性質」。
那時,川普在政策立場上闡述清晰,展現出精細的概念思考能力。他之所以與該黨決裂,是因為拒絕與新納粹人物大衛.杜克(David Duke)及極端保守民族主義者派特.布坎南(Pat Buchanan)共處。這不僅顯示他具備細膩的政治判斷,也意味著他當時仍與極右勢力保持距離――這一點,在他後來塑造的民粹形象中幾乎消失。
當時的資料顯示,他使用的是詞彙豐富、結構清晰、策略明確的政治語言,完全符合一個美國傳統政治菁英的表達模式。
這種人生軌跡上的巨變,幾乎可以確定—無論是2000年的版本,抑或2010年代至2020年代的版本,至少有一種「川普形象」是刻意建構的產物。而1980年代至1990年代及2000年的川普兩者相近,更支持以下判斷:那個語言精緻的版本,才是較為「真實」的他;至於後來成功奪取總統大位的民粹版本,則是一種策略性模擬。
「無敵語法」導師教他的第一條鐵律:永不道歉
為了達到這一境界,川普拜一位修辭大師為師,也就是科恩律師。這位律師曾是前參議員約瑟夫.麥卡錫(Joseph McCarthy)的重要顧問,活躍於美國對同情共產主義者發動大規模清算的麥卡錫主義(McCarthyism,編按:此時期也被稱為麥卡錫時代〔McCarthy Era〕,持續時間為1947年至1959年。當時在冷戰氣氛下,美國公眾對於蘇聯及共產主義擴張侵入美國感到恐懼,時任參議員麥卡錫主張反共,麥卡錫主義於是興起,針對可能支持左派的個人與團體進行政治迫害)時期。科恩將「操控」轉化為一門生存藝術。他對川普的影響,不僅僅是溝通技巧,更是一整套關於「如何在公眾場域中維持無敵形象」的哲學,其核心包括:
永遠不要道歉,也不要承認錯誤。
持續主動攻擊,避免陷入防守。
將媒體視為武器。
經營並維持權力人脈網絡。
永遠不要承認失敗,始終宣稱自己勝利。
這套「無敵語法」表現在語言上,把委婉與道歉的詞彙幾乎完全排除了;猶豫、試探的表達消失,取而代之的是不容質疑的定論。這並非論述能力退化,而是策略的進一步激進化。
科恩的影響,也體現於將每一次交流轉化為對抗:不只要擊敗,還必須羞辱對手。這種戰鬥邏輯一旦進入政治領域,便徹底改寫了美國民主辯論的規則—以追求絕對統治,取代尋求共識。川普並不「辯論」,他透過訊息的密集投放、重複與威嚇,占領整個話語空間。
這種策略,使每一次公開發言,都成為一場力量展示,細膩論證被衝擊力本身所替代。
川普的語言,就像具備子母彈(集束彈)效果的武器――他結合了母彈最初的爆裂(介於爆炸聲與衝擊波的「爆炸威力」)及隨之而來的震驚與迷失,並利用後續效應,增強第一波攻勢的影響力。接著,他的話語如同釋放的爆炸性子彈藥,堅決的持續轟炸已成死敵的對手,直到對方精疲力竭;對手則受困於負責任的姿態中動彈不得,不知該怎麼在川普布下的攻擊範圍中求生。
節錄自:大是文化《川普式無敵語法:話該怎麼說,才能贏得信任、引起共鳴、取得發言權、扭轉劣勢。注意力經濟下,我們都該學學最強大的「川普式無敵語法」。》/包(Alain Bauer) 著
推薦文章:
突然被點名致詞怎麼辦?記住「3步驟公式」,搞定人生重要場合發言
臨時發言常常翻車…關鍵差在「綠燈思維」:4情境學會目的先行
用AI快速寫Email!ChatGPT Writer、Copilot等中英文電子郵件生成|附5種指令範例
想用AI快速回信寫信,Grammarly、Microsoft Copilot、TinaMind、ChatGPT Writer要怎麼用?本文解析4種工具的特色及介面用法,以及分享5種情境的信件指令(Prompt),讓你工作效率倍增!
文/ 張可佳(Claire Chang)
本文目錄(點擊可快速前往)
Grammarly:英文書信的撰寫輔助Microsoft Copilot:善用預設介面撰寫信件撰寫商務信函指令(Prompt)商務信函的最佳化指令(Prompt)個人信件書寫指令(Prompt)職場信件書寫指令(Prompt)政府公文的撰寫指令(Prompt)TinaMind:一鍵產生信件內容ChatGPT Writer:快速寫信、自動幫你回信
書信和邀請函至今依然扮演著重要的角色,無論是正式場合還是私人活動,都需要一封得體、清晰的信件來傳達資訊和心意。利用文字生成工具來撰寫和修改書信與邀請函,無論是商務邀請、活動邀請,還是個人邀請信,都可以通過簡單的提示,生成專業且符合場合的內容。
延伸閱讀:【商業/求職Email格式】電子郵件7重點+範例,輕鬆寫出專業感
Grammarly:英文書信的撰寫輔助
官方網站:https://www.grammarly.com/
Grammarly是一個AI驅動的寫作輔助工具,主要針對英文的寫作為主,旨在幫助用戶提升寫作的準確性和表達效果。它能即時檢查文法、拼寫、標點,並提供語氣、風格等建議,也可以可根據提示生成內容大綱或草稿。
該工具支援多種平台,包括桌面應用程式、瀏覽器擴展程式、行動應用程式等,在安裝桌面版程式之後,可直接在Google Docs、Slack、Outlook等使用此工具,提供撰寫信件時的文法檢查,或是直接輸入你想寫的內容請Grammarly幫忙生成內容,而無需切換應用程式。另外Grammarly也提供瀏覽器外掛,支援Chrome、Safari、Firefox等主流瀏覽器,透過外掛可與Gmail、Google Drive等Google服務整合。
Grammarly提供免費和付費版本,某些高級的功能如:語氣建議、抄襲檢查等,只能在付費版本使用。
這個功能適合經常需要撰寫英文書信的人,其對於文法和拼寫檢查非常的準確。
Grammarly(圖/博碩文化提供)
Microsoft Copilot:善用預設介面撰寫信件
針對邀請函的撰寫,我推薦Microsoft Copilot,因為他有已經設計好的介面可供直接使用,我們只需要將Copilot的介面切換至「撰寫模式」,這邊都已經有固定的表格和選項,只要按照表單填寫,就能產生很棒的內容。
Microsoft Copilot在撰寫邀請函方面的最大優勢在於其直觀且易用的介面,特別適合不熟悉AI的使用者。以下是一些具體的優勢:
設計良好的介面:Copilot提供了一個專門的「撰寫模式」,用戶可以輕鬆切換到這一模式,無需深入了解AI技術即可開始使用。
預設模板和選項:在撰寫邀請函時,Copilot已經設計好固定的表格和選項,用戶只需選擇所需的類型,系統便會自動生成相應的內容,這樣可以節省大量的時間和精力。
自動化內容生成:Copilot能夠根據用戶的需求自動生成邀請函的內容,無論是正式的商務邀請還是輕鬆的社交聚會邀請,均能提供合適的文案。
Copilot(圖/博碩文化提供)
除了邀請函之外,同樣的模式在商務信函的撰寫與最佳化、個人和職場信件的書寫也非常有用。以下為範例的Prompt:
撰寫商務信函指令(Prompt)
寫一封有說服力的電子郵件來說服潛在客戶嘗試我們的商品。我們的商品是辣木月餅我們每盒都會捐贈100元幫助婦幼弱勢,辣木有極高的營養價值,是個天然的健康補充來源
商務信函的最佳化指令(Prompt)
修改這封電子郵件,以專業的英語口說方式寫出來,此封信件的語氣應要能非常專業和簡潔。此外,至少提供三個電子郵件主題給我選擇。""" 我們很高興向您介紹我們最新推出的產品「辣木月餅」。這款月餅結合了傳統與健康,是您中秋佳節的不二選擇。每購買一盒,我們將捐贈100元幫助婦幼弱勢群體。希望能有機會為您提供試吃樣品,讓您親自體驗這款健康美味。"""
個人信件書寫指令(Prompt)
寫一封給朋友的電子郵件,內容是邀請他們參加我即將舉辦的生日派對,並提供派對的詳細資訊如日期、時間、地點,還有希望他們能夠來的原因。
職場信件書寫指令(Prompt)
寫一封給同事的電子郵件,內容是邀請他們參加公司即將舉辦的研討會,並提供研討會的詳細資訊如日期、時間、地點,以及參加的意義。
政府公文的撰寫指令(Prompt)
寫一封給教育局的公文,內容是請求教育局通知各學校特教系分享協會即將舉辦的針對特教老師的培訓課程資訊,並附上課程的詳細資料如日期、地點及報名方式。
TinaMind:一鍵產生信件內容
我們可以至TinaMind的官網安裝瀏覽器外掛,這個外掛提供簡單易用易上手的UI,並且有非常多已經分類好、在不同領域可開箱即用的現成提示詞,我們只需要像是填表單一樣把我們的需求填入,就可一鍵產生我們要的書信內容。
官方網站:https://tinamind.com/
在介面的頂端,可以選擇是要撰寫新郵件還是回覆現有郵件。並可以選擇郵件內容的長度(自動、短、中、長)、語氣(中立、正式、專業等),並選擇輸出語言。這部分更詳細的說明可參考本書【4-2推薦的瀏覽器外掛與工具】,裡面有專門針對TinaMind外掛有更完整的介紹。
TinaMind(圖/博碩文化提供)
ChatGPT Writer:快速寫信、自動幫你回信
官方網站:https://chatgptwriter.ai/
ChatGPT Writer是一個瀏覽器外掛,能夠幫助用戶快速撰寫電子郵件、修正語法、進行翻譯及進行研究等多種操作。其與Gmail進行深度整合,讓用戶可以很方便地在Gmail信箱內使用AI。無論是撰寫電子郵件、回覆信件、訊息還是進行文本的修正與改寫都能快速完成。
ChatGPT Writer(圖/博碩文化提供)
支援多種AI模型,如GPT 4o、Claude Sonnet 3.5、Gemini 1.5 Flash等。ChatGPT Writer不僅支援多輪對話功能來調整回覆內容,或透過最下方的選單,根據需求調整寫作語氣與回應長度,並支援Markdown格式,讓回覆的內容更加適合特定的場合。最後則可以一鍵將最終的結果放回Gmail回覆欄位內。
ChatGPT Writer(圖/博碩文化提供)
ChatGPT Writer體積小巧、啟動快速,支援多語言,適合各類使用者需求。免費版的使用者一個月可使用15次,若覺得滿意升級Pro版本則月費為$16美金。
節錄自:博碩文化《AI職場超神助手:ChatGPT與生成式AI一鍵搞定工作難題/張可佳(Claire Chang) 著 》
更多【AI工具應用】推薦:
盤點20大職場必備AI工具!專家:未來9成工作者都須懂AI
ChatGPT整理Excel表格超快速!用AI輕鬆搞定複雜資料
ChatGPT一鍵生成簡報!Slides Maker讓AI幫你快速做完整簡報
Vibe Coding是什麼?為何要學習它?
Vibe coding(氛圍編程)是一種新興的 AI 輔助程式設計方式,由 OpenAI 聯合創辦人暨前特斯拉 AI 領導者 Andrej Karpathy 於 2025 年 2 月提出。程式設計師不再逐行撰寫程式碼,而是透過自然語言或對話形式,向大型語言模型(LLM)描述需求,由 AI 負責產生程式碼,程式設計師則引導、測試、優化和調整:如他所言:「完全順應感覺(vibes)、忘記程式碼的存在」。
這種方法讓使用者不需專精程式語法,只需以生活語言表達想法,AI 自動生成原始碼,開發者將更多精力集中在創意與需求上。
然而,Vibe coding的優點與缺點是什麼?程式設計師會被取代嗎?還是能變成一種新的混合模式加速開發?
來看看以下這篇文章吧!👇
https://www.xschoolkh.com/post/what-is-vibe-coding
全民英檢中級寫作怎麼準備?中譯英先達意、120字作文先切題的檢查順序
英文作文寫得很長,卻沒有回答題目;翻譯查了每個單字,整段還是不通順?全民英檢中級寫作要過關,關鍵是翻譯先達意、作文先切題。這篇用原創短翻譯與作文提示,示範下筆前要拆什麼、寫完後怎麼檢查。
本文目錄
全民英檢中級寫作考什麼?
翻譯怎麼做?訊息→關係→英文→回查
作文怎麼寫?拆提示→排內容→寫作→檢查
原創示範:短翻譯與作文提綱
修正示範:漏譯與漏答提示怎麼補
常見錯誤與檢查順序
動手做2個寫作練習
資料來源與教學說明
不需要背一整篇範文,而是要帶走可以重複使用的檢查順序。遇到新的提示,也能自己決定要放哪些資訊,不被舊範文綁住。
搭配本課程5分鐘影片,先看重點,再用下面的整理與練習確認理解。
影片/全民英檢中級入門系列第4堂:中級寫作,翻譯先達意、作文先切題
全民英檢中級寫作考什麼?
部分配分要求中譯英40%把一段中文翻成通順、達意且前後連貫的英文英文作文60%依中文文字提示寫作,約120字(8至12句),可寫成一段或分段
寫作共40分鐘,滿分100分,80分通過。評分看內容、組織、用字及語法等,不只是計算錯字。本文的短翻譯是教學示範,不代表正式整段翻譯的長度。
翻譯怎麼做?訊息→關係→英文→回查
先圈出誰、何時、做什麼。
再標出因果、轉折或替代關係。
用自己能掌握的英文把意思寫清楚。
逐項回查:時間有沒有漏?動作與地點有沒有變?有沒有加進原文沒有的理由?
不必強求每個中文字都對上一個英文字,但原文的重要意思不能消失。同一段翻譯可能有多種自然寫法,參考答案不是唯一答案。
作文怎麼寫?拆提示→排內容→寫作→檢查
作文先把題目拆成要回答的問題,再排內容順序。故事類提示可以照「原計畫、發生變動、採取行動、感受」安排,其他題目就依實際要求調整。先用幾個關鍵詞列提綱,再補完整句與必要細節,不要先背一段漂亮開頭,最後才想怎麼接題目。
檢查時先看內容與組織,再看句子:題目要求的資訊是否齊全?事件能不能依序理解?接著才查時態、主詞與動詞、拼字及標點。描述過去經驗時,主要事件通常用過去式,但不是所有作文都必須用過去式。
圖解|翻譯與作文的回查流程
原創示範:短翻譯與作文提綱
翻譯示範:昨天下大雨,所以我們取消了公園野餐。我們改在家裡一起做午餐。
參考譯文:It rained heavily yesterday, so we canceled our picnic in the park. We made lunch together at home instead.
要保留的訊息:昨天、下大雨、取消公園野餐、改在家一起做午餐,以及因果與替代關係。「我們」也要保留,不要改成只有一個人。
作文提示:請以一次沒有按照計畫進行的戶外活動為主題,寫一篇約120字的英文作文,說明原本的計畫、發生的變動、改做的活動,以及你的感受。
提示要求提綱原本的計畫朋友週日到公園野餐發生的變動準備出門時下大雨改做的活動留在住處做午餐、玩桌遊你的感受先失望,後來享受相聚
參考範文:Last Sunday, my friends and I planned to have a picnic in a park near my home. We prepared sandwiches and fruit the night before. However, heavy rain began just as we were ready to leave. We decided to stay at my apartment instead. Everyone helped make lunch, and we used the food we had prepared for the picnic. After lunch, we played a board game and shared stories about our school days. At first, I was disappointed because I had looked forward to spending time outdoors. In the end, I enjoyed the afternoon very much. The experience taught me that a change of plans can still lead to a wonderful day with friends.
範文共9句,依序回應原計畫、變動、替代活動與感受。這是原創參考,不保證級分;建議先自己寫,再對照組織方式。
修正示範:漏譯與漏答提示怎麼補
漏譯:譯文只寫「下雨,所以取消野餐」,雖然通順,卻漏掉「改在家裡做午餐」。回查第二句就知道要補替代活動;只把 canceled 換成更難的單字,漏掉的意思仍然沒有回來。
漏答提示:文章只寫下雨和取消,就缺了「替代活動」與「感受」兩項;補充也要依提示,不能只增加天氣描寫。
不切題的句子:看似漂亮卻無法回應提示的句子,應刪掉或改寫。
留下修訂紀錄:比較初稿和修訂稿,註記補回了哪一個訊息,就看得見修訂用途。
圖解|翻譯與作文的逐項回查
常見錯誤與檢查順序
翻譯只顧單字,漏掉原文關係。
作文只顧湊字數,沒有完成提示。
用自己掌握不好的複雜句型,反而讓意思不清楚。
邊讀邊改所有問題,修了小地方,卻忘記有一項提示還沒回答。
檢查時一次只看一類問題:先查內容,再查時態,最後查拼字。約120字是作答要求的一部分,不代表字數夠就一定通過。
動手做2個寫作練習
練習1:不看參考譯文,自己翻譯「昨天下大雨,所以我們取消了公園野餐。我們改在家裡一起做午餐。」再在訊息旁打勾回查。
解析:逐項確認昨天、下大雨、取消、公園野餐、改在家、一起做午餐都有出現,並保留 so(因果)與 instead(替代)的關係。
練習2:先不看範文,依本文的作文提示寫一篇約120字的英文作文。
解析:寫完用四個問題檢查——原計畫、變動、替代活動、感受是否齊全?在每句旁註明它回應哪個提示,找不到對應任務的句子,就檢查是否必要。最後才對照範文,找出一個組織方式與一個句子寫法。
資料來源與教學說明
本文的成績案例、例句、短文、對話與看圖情境皆為原創教學示範,不是官方題庫;寫作與口說提供的是參考答案,未經官方評分,也不保證特定級分。「原安排/變動/最後結果」「先答重點、再補理由」等是教學整理,不是完整的官方評分規則。報名日期、場次、成績效期與個人報考資格,請以LTTC全民英檢官網最新公告為準。
資訊查核日期:2026-10-16。
LTTC全民英檢:中級測驗說明(測驗內容、題型、通過標準)
LTTC全民英檢:中級練習題(寫作中文提示、看圖敘述題目呈現)
全民英檢中級入門系列|接著讀下一堂
第1堂|全民英檢中級怎樣算通過?聽讀160分與單項72分門檻
第2堂|中級聽力怎麼抓答案?追蹤原安排、變動與最後決定
第3堂|中級閱讀常選錯?用上下文與原文證據核對選項
第5堂|中級口說怎麼答?回答有延伸、看圖有順序
全民英檢該考哪一級?初級到優級差異、使用時機與報名流程
[joblist_plugin title='更多104【全民英檢】工作機會' url='https://www.104.com.tw/jobs/search/?keyword=%E5%85%A8%E6%B0%91%E8%8B%B1%E6%AA%A2' amount='3']
Claude Code越聊越笨?4個指令管好「上下文」,用量60%就該主動壓縮
用Claude Code寫到一半,它突然忘了前面交代的規則?問題可能出在上下文快滿了。作者拆解 /context、/compact、/clear、/resume 等4個指令,教你看懂上下文用量,在對的時機壓縮或清空。本文節錄自《Claude Code全攻略》。
文/曾慶良(阿亮老師)
本文目錄(點擊可快速前往)
為什麼要管上下文?上下文、對話歷史、費用的關係【指令1】用 /context 查上下文佔比【指令2】用 /compact 主動壓縮(60%觸發點)【指令3】用 /clear 徹底清空【指令4】/resume 對話恢復【進階】客製化statusline顯示上下文用量【建議】上下文管理SOP
使用工具:Claude Code(需付費方案,免費版不能用)
安裝說明:https://code.claude.com/docs/zh-TW/setup
不想用終端機:下載電腦版,直接在桌面程式中使用Claude Code
為什麼要管上下文?
已經學會用 /usage 看Token用量、用 /cost 看費用。但有一件事這兩個指令看不到:Claude Code的對話有「容量上限」,超過了就會開始忘東忘西。
這個容量上限叫做Context Window(上下文視窗),所有對話歷史(你的提問 + Claude的回覆 + 讀過的檔案內容)都會疊在裡面。容量越接近滿,發生的問題會越多:
上下文用量你會遇到的狀況0–40%對話流暢,Claude記得所有細節40–60%還沒事,但開始要留意60–80%Claude偶爾忘記前面講過的小細節80–90%明顯漏掉指令、忽略CLAUDE.md規則90–100%自動壓縮觸發,回覆變短、品質下降
結論:不要等Claude變笨才處理上下文。60%就該主動行動。
上下文、對話歷史、費用的關係
很多人把這3件事搞混,先釐清:
項目是什麼用什麼指令查滿了會怎樣上下文視窗這次對話Claude能「同時記住」的容量上限/contextClaude開始忘事對話歷史從這次session開始累積的所有訊息滾動畫面看持續累積,不會自動消失Token用量/費用從這次session累積的計費基礎/usage /cost撞到月費用上限
關鍵差別:
上下文滿了 → 影響智慧,要靠 /compact 或 /clear 處理
費用滿了 → 影響額度,要靠升級方案或省模型處理
兩件事獨立發生,要分開管。
【指令1】用 /context 查上下文佔比
啟動Claude Code,隨便聊幾句之後輸入:
/context
[模擬] /context 報表:
Context Window Usage
╭───────────────────────────────────╮
│ ████████░░░░░░░░░░░░░░░░░░░░░░ 28% │
╰───────────────────────────────────╯
Total capacity: 200,000 tokens
Used: 56,420 tokens (28%)
Available: 143,580 tokens (72%)
Breakdown by source:
• System prompt + CLAUDE.md 2,340 tokens (1.2%)
• User messages 14,250 tokens (7.1%)
• Assistant responses 18,920 tokens (9.5%)
• Tool results (file reads) 20,910 tokens (10.5%)
─────────────────────────────────────
Status: 健康(建議已用量保持在 60% 內)
總容量以你的模型為準:多數模型是200K tokens,但Sonnet 5 / Fable 5已提供1M context選項——/context第一行的Total capacity才是你當下的真實上限。
Fable 5的完整脈絡規格:context window 100萬(1M)token、單次輸出上限12.8萬(128K)token、資料保留30天、不支援零資料保留(ZDR)。1M聽起來很多,但單次輸出被128K綁住——長文件產出要拆段,不能期待一次吐完。
別讓模型「自己嚇自己」提早收工。高階模型有時會在額度還很充裕時,就主動說「上下文快滿了、要不要開新對話」而中斷任務。這不是真的滿了,而是它保守過頭。你可以在CLAUDE.md補一條反制指令:
可用額度充裕時,不要因為接近上限就停手、總結或建議我開新 session,
請直接繼續完成手上的工作。
這條屬於「駕馭Fable 5的指令範本」之一,和CH05那組(防過度思考、防自作主張、診斷vs.修復、memory寫法)是同一套心法——把模型保守或雞婆的預設行為,用一句話校正回來。
重點看4個分項:
來源為什麼會大Tool results讀檔次數多、檔案大時會迅速膨脹Assistant responsesClaude生成大量程式碼時User messages你貼了長文件、長日誌System prompt + CLAUDE.md永遠都在,無法縮減
/context多久看一次?沒有硬規則,但建議跑完一個複雜任務後看一次、感覺Claude變笨時看一次。
【指令2】用 /compact 主動壓縮(60%觸發點)
當 /context 顯示60%以上,就該主動壓縮。
操作:
/compact
[模擬] /compact執行畫面:
Compacting conversation...
Before: 142,830 tokens (71%)
After: 38,420 tokens (19%)
Saved: 104,410 tokens
✓ 對話歷史已壓縮成摘要,關鍵決定與檔案內容保留
✓ Claude 仍記得這次 session 做過的事,但細節已濃縮
繼續對話即可。
/compact 做了什麼?它讓Claude自己回顧整個對話,輸出一份摘要,然後用這份摘要取代原始的長對話歷史。結果是:
上下文騰出空間
主要工作脈絡保留
細節(例如某個變數的精確命名)可能會被略掉
壓縮過程本身要消耗一些Token(但通常划算)
壓縮完,馬上再跑一次/context驗證:
/context
確認已用百分比真的降下來了(例如71% → 19%)。這一步5秒鐘,能讓你確定壓縮有效,也順便體會前後差異。
何時該/compact、何時該 /clear?
情境該用還在做同一個任務,但Claude開始迷糊/compact同一個任務跑很久了,想保留脈絡/compact要切換到完全無關的新任務/clear進入第二個工作天,重新開始/clear我把上一份工作的secret不小心貼進去了/clear(立刻清掉)
【指令3】用 /clear 徹底清空
/clear
注意:/clear 是立即執行、沒有確認畫面、不可逆。按下Enter的瞬間對話歷史就清空了。清空前如果有想保留的結論,先用 /export 把整段對話匯出成檔案再清。
清空後Claude不再記得任何先前的訊息;CLAUDE.md與已安裝的Skills / Plugins不受影響。
和 /compact 的本質差別:
/compact:「我把房間整理好,東西還在」
/clear:「我把房間清空了,換新主題」
【指令4】/resume 對話恢復
有兩種情境會用到 /resume。
情境A:你不小心關掉Claude Code視窗
重新啟動:
claude --continue
[模擬]:
✓ Resuming last session from 2 minutes ago...
✓ Restored 47 messages, 38% context
> ▌
情境B:你想回到幾天前的某次對話
/resume
[模擬]對話歷史選單:
Recent Sessions
[1] 2026-05-11 14:23 (47 msgs) Flask Hello World 專案
[2] 2026-05-10 09:51 (132 msgs) 程式碼審查與重構
[3] 2026-05-09 17:08 (28 msgs) CLAUDE.md 設定
[4] 2026-05-08 11:30 (89 msgs) Skills 開發
↑↓ Navigate Enter: Resume Esc: Cancel
選擇要恢復的對話,按Enter,Claude Code把那次的所有上下文載回來。
/resume 的價值:
不需要重新貼背景資料
不需要重新解釋專案脈絡
跨日工作流可以自然續接
小提醒:claude --continue 是「續接最後一次」的快捷;/resume 是「進選單選哪一次」的完整版。
【進階】客製化statusline顯示上下文用量
這節是進階選作,只想入門的話可以直接跳過。下面整段程式碼你完全不用看懂——最省事的做法是把這整節複製起來丟給Claude,說「幫我照這節設定好statusline」,它會自己幫你寫好、掛上去。等你之後想深入再回來研究原理即可。
Claude Code的輸入框下方有一條statusline。它的機制是「外掛腳本」;Claude Code會把當前狀態打包成一包JSON從stdin餵給你指定的指令,你的腳本輸出什麼文字(第一行),statusline就顯示什麼。設定長這樣:
{
"statusLine": {
"type": "command",
"command": "python ~/.claude/statusline.py"
}
}
沒有format、refreshInterval這類欄位——顯示邏輯全部由你的腳本決定,這正是它強大的地方。
目標效果:
> ▌
~/Desktop/flask-hello | Sonnet 5 | ctx 已用 42%
步驟1:建立statusline腳本
把下面的跨平台Python腳本存成~/.claude/statusline.py(直接把本節整段丟給Claude請它代勞也行):
#!/usr/bin/env python3
# ~/.claude/statusline.py — 顯示「目錄 | 模型 | context 已用%」
import sys, json, os
data = json.load(sys.stdin)
# 1) 目前工作目錄(家目錄縮寫成 ~)
cwd = data.get("workspace", {}).get("current_dir") or data.get("cwd", "")
home = os.path.expanduser("~")
if cwd.startswith(home):
cwd = "~" + cwd[len(home):]
# 2) 模型顯示名
model = data.get("model", {}).get("display_name", "?")
# 3) context 已用百分比(欄位名依版本而異,逐一嘗試;拿不到就顯示 --)
pct = None
ctx = data.get("context_window") or data.get("context") or {}
used = ctx.get("used_tokens") or ctx.get("used")
size = ctx.get("max_tokens") or ctx.get("size") or ctx.get("context_window_size")
if used and size:
pct = round(used * 100 / size)
if pct is None:
ctx_text = "ctx --"
else:
color = "\033[32m" # 綠:健康
if pct >= 80: color = "\033[31m" # 紅:立刻 /compact 或 /clear
elif pct >= 60: color = "\033[33m" # 黃:準備行動
ctx_text = f"{color}ctx 已用 {pct}%\033[0m"
print(f"📁 {cwd} | 🤖 {model} | 🧠 {ctx_text}")
Claude Code傳入的JSON欄位會隨版本演進(以官方文件Status line章節為準)。想親眼看看拿到什麼,可在腳本開頭暫時加一行 open(os.path.expanduser("~/statusline_debug.json"), "w").write(json.dumps(data)) 再打開檔案研究。
步驟2:把腳本掛進settings.json
編輯 ~/.claude/settings.json,加入(或請Claude加入)本節開頭那段statusLine設定。Windows用戶把command寫成:
"command": "python \"%USERPROFILE%\\.claude\\statusline.py\""
步驟3:重啟Claude Code驗證
/exit
claude
[模擬]啟動後的statusline:
> ▌
~/Desktop | Sonnet 5 | ctx 已用 8%
聊一陣子後,已用量爬到60%會轉黃、80%轉紅——紅色就是強烈建議 /compact 或 /clear 的時刻。
設定完成後,輸入框下方顯示目錄、模型與上下文已用百分比(圖/博碩出版《Claude Code全攻略》)
【建議】上下文管理SOP
把這套流程記下來,之後不用每次想:
任務開始
↓
[每次切換主任務] → /clear
↓
工作中⋯
↓
[statusline 顯示已用 60% 以下(綠)] → 繼續
[已用 60–80%(黃)] → 留意,準備收尾或 /compact
[已用 80% 以上(紅)] → 立刻 /compact 或 /clear
↓
任務完成
↓
[需要明天續接] → 直接 /exit(明天 claude --continue)
[已徹底完成] → /clear
[要切換到無關的新任務] → /clear
↓
明天回來
↓
[續上次任務] → claude --continue
[選歷史對話] → /resume → 選清單
[全新主題] → 直接 claude
節錄自:博碩文化《Claude Code全攻略:從一句話到部署上線,打造你的AI Agent開發團隊》/曾慶良(阿亮老師) 著
推薦閱讀:
Claude Code Subagent怎麼用?3分鐘建好子代理,判斷何時該多Agent分工
商務Email好難回?用Claude Skill建回信SOP,4大類型自動判斷
「Skill」和「提示詞」差在哪?6大差異與SKILL.md寫法一次看
ChatGPT生成Apps Script程式碼4技巧!Google Sheets自動化範例用AI加持
想把重複的Google Sheets試算表工作自動化,用ChatGPT就可以快速生出可用的Apps Script程式碼,相較於手動編寫、錄製巨集,使用生成式AI的技術門檻最低!作者分享2個範例,並提醒用AI生成Apps Script程式碼的Prompting技巧。本文節錄自《AI 加持!Google Sheets 超級工作流》。
文/杜昕 Mic Tu
本文目錄(點擊可快速前往)
撰寫Apps Script程式碼的3種方式使用生成式AI生成Apps Script程式碼▶ 範例1:資料統計▶ 範例2:生成圖表用AI生成Apps Script程式碼的Prompting技巧
Google Apps Script(以下簡稱Apps Script)是一個強大的雲端腳本語言,讓使用者能透過類似JavaScript的程式碼整合Google的試算表、文件、簡報、日曆等功能,自動化重複性的工作,完全免費且不需要安裝任何開發環境即可完成。
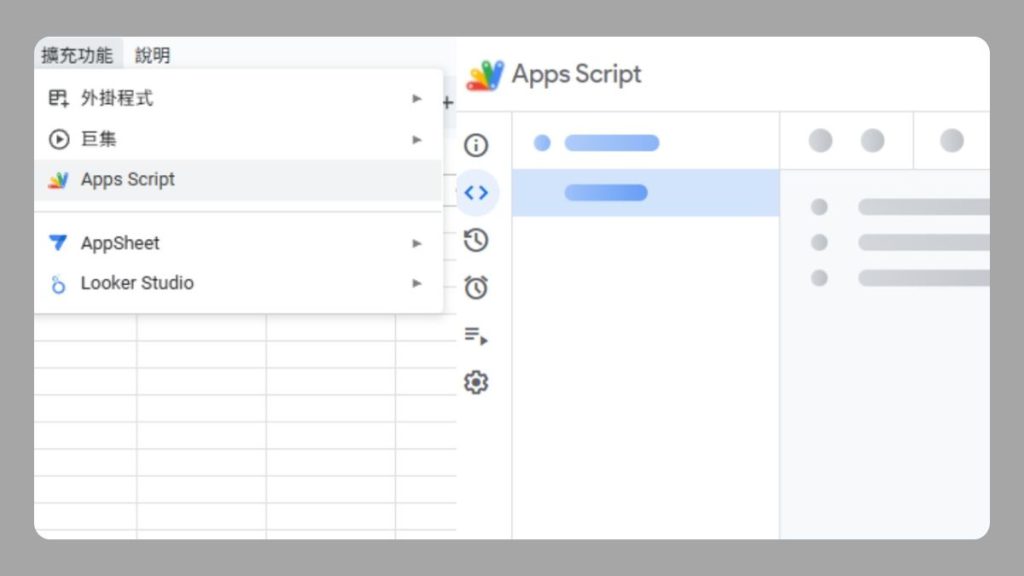
若要在Google Sheets中使用Apps Script,只要點選「擴充功能 → Apps Script」進入Apps Script的編輯器介面,便能開始撰寫程式。
撰寫Apps Script程式碼的3種方式
撰寫Apps Script程式碼的方式可分成手動編寫、錄製巨集、使用生成式AI 3種,優缺點分別如下:
撰寫方式優點缺點手動編寫完全根據需求客製化程度高。需要花較多的時間學習與實際撰寫。錄製巨集錄製後自動生成程式碼,只需根據需求手動調整即可。錄製的程式碼較基本,複雜的需求可能要大幅的手動調整,因此仍需具備程式基礎。使用生成式AI可直接複製貼上生成的程式碼,大幅提高撰寫效率,也能解決較複雜的案例。撰寫程式碼時會備註各程式碼的用途,可供快速學習。較冷門的需求可能會回答錯誤,若要提升生成品質則會需要訂閱。有時程式碼較冗餘,影響執行效能與可閱讀性。
雖然3種方式皆有優缺點,但使用生成式AI需要的時間、技術門檻最低,因此後續各章節主要會使用ChatGPT生成程式碼,提供輸入的Prompt及對應的輸出。
使用生成式AI生成Apps Script程式碼
本節將使用兩個範例說明如何使用ChatGPT生成程式碼,只要將程式碼複製到Apps Script中並執行函式即可,兩範例的需求、Prompt與ChatGPT (4o mini)生成程式碼如下:
本節範例使用之「會員資料檔」Google Sheets
會員資料檔範例(圖/旗標)
▶ 範例1:資料統計
需求:統計會員資料檔中的會員職業,各職業依會員數多到少排序。
問:生成Apps Script程式碼,統計工作表「會員資料檔」的 E2:E 每個值出現的次數,依次數由高到低輸出到工作表「5.4.3 使用生成式 AI 生成程式碼」的 A:B 中,並將兩欄的標題分別設為「職業」和「會員數」。
ChatGPT輸出結果(以下為作者撰寫時生成之版本,每次生成可能有些許差異,請各位讀者稍加留意):
▶ 範例2:生成圖表
需求:延續上例,將統計結果繪製成柱狀圖。
問:生成Apps Script程式碼,將工作表「5.4.3 使用生成式AI生成程式碼」的 A2:B 繪製成柱狀圖,兩欄分別為「職業」和「會員數」,並貼上至工作表的 C1 儲存格中。
ChatGPT 輸出結果:
兩範例的最終結果如下圖所示:
(圖/旗標)
用AI生成Apps Script程式碼的Prompting技巧
在撰寫Prompt時要清楚描述需求,以增加生成式AI正確的機率,可以使用以下的Prompting架構增加正確輸出的機率:
問:(1) 生成Apps Script程式碼,(2) 完成以下步驟:1. (3) 將工作表「○○○」的 ○○:○○ 儲存格 (4) 匯總 / 繪製圖表 / 計算...,其中 A / B / C 欄位依序為 △△△ / △△△ / △△△…。2. 將 …3. 將 …,(3) 把最終結果輸出至工作表「○○○」的 ○○ 儲存格。
(1) 在一開始就提及Apps Script,避免AI輸出其他程式語言。
(2) 若要求非常複雜時,建議化為多個步驟,或是分多次Prompt漸進式說明。
(3) 清楚說明資料來源與最終輸出的位置,提及「工作表/儲存格/範圍/欄/列」避免判斷錯誤,並建議用括號標示工作表名稱。
(4) 說明計算過程時可以說明應用場景,但要說明各欄位的名稱,避免判斷錯誤。若欄位的名稱較難判斷資料型態時,可以增加舉例說明。
節錄自:旗標《AI 加持!Google Sheets 超級工作流》/杜昕 Mic Tu 著
推薦閱讀:
AI家教上線!ChatGPT和Gemini學習模式實測4招馬上用
AWS免費課程幫你打造AI「學力」證明,攻搶12萬AI職缺!
除了ChatGPT還有哪些生成式AI?16種AI工具應用解析
30份檔案作文一次改完!Codex批次處理怎麼做?用「批次流水線5元件」自動產出總表
需要大量處理30份作文、50張發票、200份履歷,還在一份一份丟給AI嗎?本文作者以批次「批改作文」為例,拆解「批次流水線5元件」,教你用Codex建立可重用的批次Skill,跑完自動產出彙整總表;文末也整理了發票、履歷、合約3種行業的改法,可以直接對照。本文節錄自《ChatGPT × Codex全攻略》。
文/曾慶良(阿亮老師)
本文目錄(點擊可快速前往)
目標:多檔案批次處理工作流不同職業完成後能拿來幹嘛?動手做前準備清單批次流水線5元件:缺一個就會出事動手實作:多檔案批次處理工作流3種行業版本:批次處理發票、履歷、合約
目標:多檔案批次處理工作流
「把30-100個檔案丟到一個資料夾,告訴Codex動作,多核心並行跑、失敗自動重試、跑完丟出summary.xlsx」,這是學完本文後你的日常。
輸入:input/內30個.docx(或.pdf / .jpg)。
輸出:output/內30個結果檔 + logs/batch.log + summary.xlsx。
阿亮獨家「批次流水線5元件」:
批次讀取 → 並行 → 進度 → 重試 → 彙整
5元件缺一不可。本文把它包成一個可重用的批次Skill,之後處理任何「N個檔案」需求,一句話就觸發。學完不只批改作文,發票OCR、履歷篩選、合約風險檢測都用同一套。
不同職業完成後能拿來幹嘛?
行業批次任務輸出教師30份.docx作文 → 評語30個.md + summary.xlsxSOHO50張發票.jpg → OCR50個.json + invoices.xlsxHR200份履歷.pdf → 5維評分每份.md + 通過/待面試/不通過名單律師50份合約.pdf → 風險條款每份摘要 + 整體評估.xlsx
動手做前準備清單
項目規格Codex CLI已裝,Codex CLI 、桌面App原始檔案30-100個同類檔案(.docx / .pdf / .jpg)檔案位置全部放在同一個資料夾單檔處理動作清楚知道「對單檔要做什麼」Python套件concurrent.futures、pandas、依檔型python-docx / pypdf / Pillow(Codex自動裝)
批次流水線5元件:缺一個就會出事
元件做什麼沒有的後果1 批次讀取掃描資料夾、過濾副檔名漏檔、誤讀2 並行多核心同時處理30份跑30倍時間3 進度每N份印一次「15/30」不知道卡住還是在跑4 重試單檔失敗最多3次1個壞檔讓整批停擺5 彙整個別輸出 + summary.xlsx30個檔不知道整體結果
兩種「並行」不要混為一談:
類型工具用在哪並行單位Python腳本層並行concurrent.futures一支Python程式同時跑8個檔案OS執行緒/行程Codex對話層並行Codex內部subagents一個Codex任務fork多個subagentLLM推理session
本章用「腳本層並行」:對30個檔案跑同一個邏輯,每個檔案不需要獨立的LLM推理。如果每個檔案都用subagent跑,會吃掉30倍token,慢又貴。subagent留給「30篇論文同時做深度摘要」這類需要獨立思考的任務。
補充:2026新利器spawn_agents_on_csv當你的任務確實需要「每一列開一個獨立分身去想」(例如30位學生各自寫一段深度個人化評語、300筆客戶各自產一份分析),Codex子代理人支援spawn_agents_on_csv,餵一份CSV,它會逐列派工給多個subagent,並可指定統一的輸出schema(設定寫在子代理人TOML)。判斷原則不變:同一套邏輯套N個檔 → 用本文的腳本層並行就好;每個檔要獨立思考 → 才動用spawn_agents_on_csv。
動手實作:多檔案批次處理工作流
步驟1:建環境
macOS / Linux:
mkdir -p ~/batch-work/{input,output,logs}
cd ~/batch-work
Windows PowerShell:
mkdir $HOME\batch-work\input
mkdir $HOME\batch-work\output
mkdir $HOME\batch-work\logs
cd $HOME\batch-work
分成3個資料夾是好習慣:input只放原始檔(唯讀心態)、output只放結果、logs存執行紀錄,失敗時就知道去哪找錯誤。
手上沒有30份檔案可測?
也可以直接對Codex下指令:「幫我生30份500字模擬作文存成input/essay_01.docx ~ essay_30.docx,品質故意做出高中低差」。
把30個檔案丟進input/,注意3件事:
直接複製到input/,不要在裡面再分子資料夾,批次腳本預設掃單層
檢查副檔名一致(避免.docx跟.doc混在一起)
確認檔案數對:
macOS / Linux:
ls input/ | wc -l
Windows PowerShell:
(dir input\).Count
(圖/博碩文化《ChatGPT × Codex全攻略)
步驟1-1:先建essay-feedback Skill(批次要呼叫的單檔工具)
這裡最容易卡住:步驟3的批次prompt會「每份套用essay-feedback Skill」,所以這支Skill要先存在,批次才有東西可以呼叫。它就是把「三段式思考(CoT)」批改流程包成Skill的小工具,現在花5分鐘就能建好。
建立方式:先用下方指令開一個Skill資料夾,再用記事本或VS Code在資料夾裡新增SKILL.md,貼上下方「essay-feedback 隨書附檔」的完整內容:
# macOS / Linux
mkdir -p ~/.agents/skills/essay-feedback
# Windows PowerShell
mkdir $HOME\.agents\skills\essay-feedback
essay-feedback 隨書附檔:
---
name: essay-feedback
description: 批改一篇學生作文(.docx / .md / .txt)並產生 100-150 字個人化評語。觸發詞:作文批改、評語、essay feedback、作文評語產生器、批改作文。
---
# 作文評語產生器
## Steps
1. 讀入單一作文檔(純文字、不含格式)
2. **Stage 1 step-through**:
- 字數統計(總字數 / 段落數)
- 主旨抓取(一句話總結這篇在寫什麼)
- 結構分析(起承轉合 / 論點論據 / 時序)
3. **Stage 2 self-audit**:
- 列 3 個「寫得好的地方」(必須引用原文片段,不可空話)
- 列 3 個「可改善的地方」(必須具體、可執行)
4. **Stage 3 final answer**:
- 寫 100-150 字評語:肯定 1 個強項 + 建議 2 個改進 + 勉勵 1 句
- 評語語氣:對國中小學生用鼓勵語氣;對高中以上用建設性語氣
## Rules
- MUST:評語必須引用作文原文(用「『...』」括起來,至少 1 處)
- MUST:建議必須可執行(「下次寫人物時可以加一個具體動作」而不是「加油」)
- MUST:字數 100-150(不可超過 150)
- NEVER:「同學們」「你們」「大家」(這是給個人的評語)
- NEVER:「應該」「必須」「一定要」(建議句改用「可以試試看」「下次或許」)
- NEVER:在沒讀作文的情況下產評語(空檔案直接回報「檔案無內容」)
## Output Format
```text
【評語】
(100-150 字評語段落)
【強項引用】
原文:「...」
評:(一句話說明為什麼好)
【改進建議】
1. (具體可執行)
2. (具體可執行)
```
核心是frontmatter的name: essay-feedback + description觸發詞,加上三段式批改流程與MUST/NEVER規則。
順帶一提,建立Skill有三種方式:$skill-creator引導式、macOS Codex App的Record & Replay錄製、手動建立資料夾,像這種內容已經寫好的小Skill,手動複製最快。
驗證有沒有生效,進Codex對話丟一句:
用 essay-feedback 跑一份測試作文(隨便貼 200 字進來)
看到「【評語】【強項引用】【改進建議】」三段結構化輸出 = 安裝成功。
(圖/博碩文化《ChatGPT × Codex全攻略)
步驟2:寫批次Skill
用「批次作文批改」當範例。SKILL.md路徑:
~/.agents/skills/batch-grade-essays/SKILL.md
(user級;若要團隊共用改repo級.agents/skills/...。)
完整內容:
---
name: batch-grade-essays
description: 對資料夾下所有 .docx 跑「作文評語產生器」並彙整 summary。當使用者說「批次批改」「批次作業」「整批評語」「資料夾批改」時觸發。
---
# 批次作文批改
## Steps
1. 掃描 ~/batch-work/input/ 下所有 .docx
2. 對每份:
2.1 讀取內容(python-docx)
2.2 套 essay-feedback(作文評語產生器)Skill
2.3 輸出 ~/batch-work/output/[原檔名]_評語.md
2.4 紀錄到 logs/batch.log
3. 並行處理(最多 8 個同時,依 CPU 核心數)
4. 失敗重試 3 次
5. 全完成產 summary.xlsx
## Rules
- MUST:每檔獨立處理(一份失敗不影響其他)
- MUST:失敗紀錄含原因(檔名 + 錯誤訊息)
- NEVER:跑到一半放棄整批
- NEVER:覆蓋 output 已存在的檔案(除非加 --force)
- SHOULD:每 5 份印一次進度
- SHOULD:跑完印「成功 X、失敗 Y、總耗時 Z」
## Tools(依檔案類型選用)
- .docx:python-docx
- .pdf:pypdf(純文字 PDF);掃描型 → pdfplumber 或先 OCR
- .jpg / .png:Pillow + pytesseract
- .xlsx / .csv:pandas + openpyxl
- 並行:concurrent.futures.ThreadPoolExecutor(I/O bound 如 OCR / API)
ProcessPoolExecutor(CPU bound 如純運算)
註:
I/O bound:卡在「等讀寫、等網路回應」的工作,例如OCR、呼叫API,適合用ThreadPoolExecutor。
CPU bound:卡在「純算數」的工作,適合用ProcessPoolExecutor。分不清就先用ThreadPoolExecutor,本文的檔案處理多半屬前者。
Rules是Codex的「品管SOP」,寫得越明確,AI越不會偷工。
步驟3:跑批次
先搞懂機制,別被SKILL.md的「2.2套essay-feedback」誤導:Python腳本本身不能「呼叫」另一支Skill。真正的分工是,Codex在對話裡對每份檔案套essay-feedback產出評語,concurrent.futures這類腳本層並行只負責讀檔、寫檔、記log這種I/O苦力。所以下面「觸發批次Skill」時,是Codex逐檔重跑審文工作流,不是一支Python迴圈自己把評語生出來。要離線排程無人值守時,改用codex exec逐檔驅動。
觸發Skill:
請執行「批次作文批改」Skill:
- 輸入:~/batch-work/input/
- 輸出:~/batch-work/output/
- 並行數:8(4 核 CPU 改 4,看你機器)
- 每份套用:essay-feedback Skill
(步驟 1-1 已建好 ~/.agents/skills/essay-feedback/)
- 每 5 份印進度
並行數不要設太高:設16-32容易被OpenAI rate limit擋掉,或記憶體會爆掉。先設定4或8試試看。
進度輸出長這樣:
[batch-grade-essays] Start: 30 files, 8 workers
[5/30] ok 001_王小明.docx
[10/30] ok 002_李大華.docx
[15/30] ok 005_陳小美.docx
[20/30] FAIL 008_格式怪.docx (retry 1/3)
[20/30] FAIL 008_格式怪.docx (retry 2/3)
[25/30] ok 012_張小華.docx
[30/30] ok 030_趙最後.docx
============ Summary ============
成功:29
失敗:1 (008_格式怪.docx,重試 3 次仍 ERROR)
總耗時:1m 47s
詳見 logs/batch.log
(圖/博碩文化《ChatGPT × Codex全攻略)
看到「成功X、失敗Y、耗時Z」三行 = 批次跑完,可以開始檢查失敗檔。
(圖/博碩文化《ChatGPT × Codex全攻略)
步驟4:驗收 + 處理失敗 + 彙整
數一下output:
macOS / Linux:
ls ~/batch-work/output/ | wc -l # 預期 30(或 29 + 1 失敗)
grep "ERROR" ~/batch-work/logs/batch.log
Windows PowerShell:
(dir $HOME\batch-work\output\).Count
Select-String "ERROR" $HOME\batch-work\logs\batch.log
數對就代表正常。如果少了幾份,查看log內的ERROR,把失敗檔名抓出來。
處理失敗檔(不要整批重來):
請看 ~/batch-work/logs/batch.log,
找出標記 ERROR 的檔案與原因。
對每個失敗檔:
1. 顯示原因(檔案損毀、格式不支援、套件版本不對)
2. 提出對策(修檔、跳過、改規則)
3. 只重跑這幾個失敗檔,不要動已成功的
請切記,不要整批重跑,因為已成功的會被覆蓋一次,浪費API額度。
產出summary.xlsx:
請產 ~/batch-work/output/summary.xlsx:
欄位(每檔一列):
- 學生姓名(從檔名抓)
- 字數 / 強項 / 改進項
- 評語連結(指向 output 內的 .md)
- 處理時間(秒)
- 狀態(成功 / 失敗 + 原因)
加 Excel 篩選器:
- 可以篩「字數不足」
- 可以篩「需特別關注」
- 可以篩「狀態 = 失敗」
summary.xlsx長這樣:
姓名字數強項改進項評語連結耗時狀態王小明520結構清楚用詞貧乏001_王小明_評語.md3.2成功李大華380敘事生動字數不足002_李大華_評語.md2.8成功008_格式怪-----失敗
老師/主管1分鐘看完全部處理結果。
(圖/博碩文化《ChatGPT × Codex全攻略)
3種行業版本:批次處理發票、履歷、合約
SOHO版:50份發票OCR
項目怎麼改輸入50張發票.jpg / .png單檔動作OCR萃取「金額、日期、發票號、品名」輸出每張一個.json + 統合invoices.xlsx套件Pillow + pytesseract(或請Codex用視覺辨識)
Codex可直接讀圖(在對話內attach圖檔當輸入),不一定要本機跑tesseract。歪斜、低解析的手機翻拍照,傳統OCR常吃鱉,先拿3張試Codex視覺辨識,跟pytesseract結果比一比,再決定整批走哪條路。
【注意】要走pytesseract路線,得先另裝Tesseract本體pip install pytesseract只裝了Python的橋接層,真正做OCR的Tesseract引擎要另外安裝(Windows下載官方安裝檔、macOS brew install tesseract、Linux apt install tesseract-ocr),還要加裝繁中語言包chi_tra。嫌麻煩就直接走Codex視覺辨識,省掉這一整串安裝。
HR版:200份履歷篩選
項目怎麼改輸入200份履歷.pdf單檔動作CoT + 評分Skill(5維評分 + 一句評語)輸出每份一個.md + summary(通過/待面試/不通過)並行建議4-8(pypdf解析PDF慢)
履歷含個資:用Codex評分時,履歷內容會送交OpenAI處理,不是純本機。先去識別化(遮掉姓名、電話、地址、身分證)再丟給Codex;要完全不外傳,就用Codex寫好的評分腳本自己在本機跑,並跑完刪對話歷史。
律師版:50份合約找風險
項目怎麼改輸入50份合約.pdf單檔動作三段CoT找風險條款(保密、違約、解約、智財權)輸出每份一份風險摘要.md + 整體評估表.xlsx並行2-4(保守,合約敏感寧可慢不要錯)隱私合約內容會經OpenAI,走Business / Enterprise方案(資料不作訓練、可簽DPA);極機密改用組織核可的離線工具,或先去識別化再跑
節錄自:博碩文化《ChatGPT × Codex全攻略:從零基礎到自動化,打造你的AI Agent工作流》/曾慶良(阿亮老師) 著

有任何收穫或想分享的,都來和大家一起聊聊吧!